Concevoir une API REST
Ce cours est distribué gratuitement sous licence CC BY-NC-SA 4.0 par Thibaud FRICHET - formation.tfrichet.fr
Prérequis :
- Bases de Python,
- Utilisation de la ligne de commande.
- Chapitre 1 - Le web et HTTP
- Petite histoire des API
- Anatomie d'une requête HTTP
- Qu'est-ce qu'une API distante ?
- Panorama : REST, SOAP, GraphQL et les autres
- TP : Trouver l'API cachée d'un site
- Chapitre 2 - Les principes REST
- Les 6 contraintes REST
- Ressources, URI et représentations
- Les verbes HTTP
- Les codes de statut
- Le modèle de maturité de Richardson
- Chapitre 3 - Outils et fil rouge
- Chapitre 4 - Consommer une API en code
- Appeler une API avec requests
- Pagination, erreurs, 401 et 429
- Les machines consomment aussi vos API
- TP : Script de statistiques
- Chapitre 5 - Concevoir une API
- Nommer les ressources et les routes
- Filtres, tri et pagination
- Versioning
- Les erreurs avec problem+json
- Exercice : L'API du stagiaire de 2009
- Chapitre 6 - Documenter avec OpenAPI
- Lire un contrat OpenAPI
- Structure YAML et schémas
- Code-first ou design-first
- Swagger UI, Redoc et Scalar
- Générer des clients
- Chapitre 7 - Exposer une API
- Premiers pas avec FastAPI
- Routes, paramètres et body
- Validation et codes de retour
- TP : Les avis
- Pour aller plus loin : persistance et mock
- Chapitre 8 - Sécurité et bonnes pratiques
- Chapitre 9 - HATEOAS
Chapitre 1 - Le web et HTTP
Petite histoire des API
Aujourd'hui, la plupart des usages numériques (lire ses mails, poster du contenu, utiliser une IA, etc.) déclenchent des dizaines d'appels API. Ça n'a pas toujours été le cas : petit retour en arrière...
Le web 1.0 : des pages et des formulaires
Au début des années 90, le web sert à afficher des documents. Le navigateur demande une page, le serveur la renvoie. Et c'est tout !
- Pas de JavaScript : il arrive en 1995 et sert surtout à faire clignoter des images.
- Retour dans le passé : https://spacejam.com/1996/
- Seulement deux verbes HTTP utilisés en pratique :
GETpour afficher une page etPOSTpour envoyer un formulaire. - Chaque action recharge toute la page.
<form action="/livre-dor.php" method="POST">
  <input name="message" value="Super site, bravo au webmaster !">
  <button>Signer le livre d'or</button>
</form>
Les autres verbes (PUT, DELETE…) existent dans HTTP depuis 1996, mais un formulaire HTML <form> ne sait toujours envoyer que GET ou POST, même en 2026.
Faire parler les machines entre elles
À la fin des années 90, les entreprises veulent que leurs programmes s'échangent des données, pas seulement des pages pour humains.
- 1998 – XML-RPC, puis SOAP : on appelle une fonction à distance en envoyant une enveloppe XML. Puissant, mais très verbeux.
- 2000 – REST : dans sa thèse, Roy Fielding (un des auteurs de HTTP) décrit un style d'architecture qui utilise le web tel qu'il est : des ressources, des URL et les verbes HTTP.
- 2002 – Le mémo Bezos : chez Amazon, toutes les équipes doivent exposer leurs données uniquement via des interfaces de service. Ceux qui ne le font pas seront licenciés. Ambiance. C'est l'ancêtre d'AWS.
Le web devient une application
- 2005 – AJAX : Gmail et Google Maps chargent des données en arrière-plan sans recharger la page. Le navigateur devient un client d'API.
- 2007 – l'iPhone : les applications mobiles n'affichent pas de HTML, elles ont besoin de données brutes. Il faut des API partout.
- Années 2010 – l'ère des API publiques : Twitter, Google Maps, Stripe, OpenWeather… Des entreprises vendent même uniquement une API. JSON remplace XML.
- 2015 – OpenAPI (ex-Swagger) : un format standard pour décrire une API.
Aujourd'hui : les machines consomment les API
Les applications « SPA » (React, Vue…) sont des coquilles vides qui récupèrent tout leur contenu par API.
Une API bien conçue et bien documentée sert aussi bien un développeur humain qu'une IA. C'est le fil conducteur de ce cours.
| Année | Étape |
|---|---|
| 1991 | Le web : pages et formulaires |
| 1998 | XML-RPC, puis SOAP |
| 2000 | Thèse de Fielding : REST |
| 2005 | AJAX |
| 2007 | iPhone : les API deviennent indispensables |
| 2010+ | API publiques, JSON |
| 2015 | OpenAPI |
| 2024 | MCP : les IA consomment les API |
Anatomie d'une requête HTTP
HTTP (HyperText Transfer Protocol) est le protocole du web. Le principe est simple : un client envoie une requête, le serveur renvoie une réponse. Toujours dans ce sens, toujours une réponse par requête.
Voir HTTP en vrai
L'option -v (verbose) de curl affiche tout l'échange :
curl -v https://formation.tfrichet.frLes lignes qui commencent par > sont envoyées par le client, celles qui commencent par < sont reçues du serveur.
La requête
Exemple avec JSONPlaceholder, une fausse API publique faite pour s'entraîner :
curl -v https://jsonplaceholder.typicode.com/posts \
  -H "Content-Type: application/json" \
  -d '{"title": "Hello", "body": "Mon premier article", "userId": 1}'
POST /posts HTTP/1.1
Host: jsonplaceholder.typicode.com
User-Agent: curl/8.10.1
Accept: */*
Content-Type: application/json
{"title": "Hello", "body": "Mon premier article", "userId": 1}- Ligne de requête : la méthode (
POST), le chemin (/posts) et la version de HTTP. - Headers : des paires
Nom: valeurqui donnent des informations sur la requête. - Ligne vide, puis le body (facultatif) : les données envoyées.
La réponse
HTTP/1.1 201 Created
Content-Type: application/json; charset=utf-8
Location: https://jsonplaceholder.typicode.com/posts/101

{"title": "Hello", "body": "Mon premier article", "userId": 1, "id": 101}- Ligne de statut : la version, le code de statut et sa description.
- Headers, ligne vide, puis le body.
Les headers à connaître
| Header | Sens | Rôle |
|---|---|---|
Host |
Requête | Le nom de domaine visé (plusieurs sites peuvent partager un serveur) |
Content-Type |
Les deux | Le format du body envoyé : application/json, text/html… |
Accept |
Requête | Le format que le client souhaite recevoir |
Authorization |
Requête | Les informations d'authentification |
User-Agent |
Requête | Le logiciel client |
Set-Cookie / Cookie |
Réponse / Requête | Le serveur dépose un cookie, le client le renvoie ensuite |
Location |
Réponse | L'adresse d'une ressource créée ou d'une redirection |
Oublier Content-Type: application/json en envoyant du JSON est l'erreur numéro 1. Le serveur ne sait pas comment lire le body et répond souvent par une erreur peu claire.
Un protocole sans état
HTTP est sans état (stateless) : le serveur ne se souvient de rien entre deux requêtes. Chaque requête doit contenir tout ce qu'il faut pour être comprise.
Alors comment un site sait-il que vous êtes connecté ? Le client renvoie à chaque requête une preuve d'identité : un cookie pour un site web, un token ou une clé d'API pour une API.
HTTP n'a pas de mémoire persistante. Ce n'est pas un défaut : c'est ce qui permet de répartir les requêtes sur plusieurs serveurs.
Les familles de codes de statut
| Famille | Signification | Exemples |
|---|---|---|
| 1xx | Information, patientez | 101 Switching Protocols |
| 2xx | Succès | 200 OK, 201 Created, 204 No Content |
| 3xx | Redirection, c'est ailleurs | 301 Moved Permanently, 304 Not Modified |
| 4xx | Erreur du client : c'est ta faute | 400 Bad Request, 401, 404 Not Found |
| 5xx | Erreur du serveur : c'est la mienne | 500 Internal Server Error, 503 Service Unavailable |
Le détail des codes est vu au chapitre 2.
Et HTTPS, HTTP/2, HTTP/3 ?
- HTTPS : le même HTTP, mais chiffré par TLS.
- HTTP/2 et HTTP/3 : le transport est plus rapide (multiplexage, QUIC), mais les méthodes, headers et codes restent les mêmes. Tout ce cours s'applique.
Qu'est-ce qu'une API distante ?
API signifie Application Programming Interface : une interface qui permet à un programme d'utiliser les fonctionnalités d'un autre, sans connaître son fonctionnement interne.
L'analogie du restaurant : vous (le client) ne rentrez pas en cuisine. Vous passez commande au serveur avec un vocabulaire défini (la carte), et il vous rapporte le plat. Le serveur, c'est l'API.
Une API distante
Une API distante (ou API web) est exposée sur le réseau, en général via HTTP. Le client et le serveur sont deux programmes séparés, souvent sur deux machines différentes, écrits dans des langages différents.
curl https://api.github.com/users/thibaudfrichet{
"login": "thibaudfrichet",
"id": 277130160,,
"name": "Thibaud Frichet",
"public_repos": 5,
...
}Un programme Python, une application mobile ou un script bash peuvent tous obtenir ces informations, sans savoir comment GitHub les stocke.
Son rôle : faire communiquer des services ou des applications entre eux.
- un front (SPA, application mobile) avec son back ;
- deux services d'une même entreprise ;
- votre application avec un service tiers (paiement, météo, cartographie…) ;
- un assistant IA avec vos outils.
Ce qu'on appelle aussi « API »… mais qui n'est pas distant
| Exemple | API ? | Distante ? |
|---|---|---|
La bibliothèque math de Python, lodash en JS |
Oui, API d'une bibliothèque | Non : appel de fonction dans le même programme |
document.querySelector() |
Oui, API DOM du navigateur | Non : fournie par le navigateur |
Les appels système Linux (open, read) |
Oui, API du noyau | Non |
| Une base de données MariaDB / MySQL | Elle a un protocole, mais on ne parle pas d'API web | Elle est sur le réseau, mais ce n'est pas du HTTP |
https://api.github.com/users/thibaudfrichet |
Oui | Oui |
SSH, MySQL, RDP, etc. : Ce sont des protocoles, comme HTTP. On ne parle pas d'API dans ce cas.
API, webservice, microservice
- API : le contrat, l'interface (les routes, les formats, les règles).
- Webservice : un service accessible par le réseau qui expose une API. Le terme est surtout utilisé pour l'époque SOAP.
- Microservice : une manière de découper une application en petits services indépendants, qui communiquent entre eux… par API.
Panorama : REST, SOAP, GraphQL et les autres
REST n'est pas la seule façon de construire une API. Voici les principales, avec le même besoin à chaque fois : récupérer le livre n°3 d'une bibliothèque en ligne.
REST
Des ressources identifiées par des URL, manipulées avec les verbes HTTP. Le format est libre, JSON dans la grande majorité des cas.
GET /v1/livres/3 HTTP/1.1
Accept: application/json
{"id": 3, "titre": "Le Petit Prince", "auteur": "Antoine de Saint-Exupéry"}Simple, lisible, compatible avec tout ce qui parle HTTP. C'est le sujet de ce cours.
SOAP
Un appel de fonction à distance, emballé dans une enveloppe XML, toujours en POST. Le contrat est décrit dans un fichier WSDL.
<soap:Envelope xmlns:soap="http://www.w3.org/2003/05/soap-envelope">
  <soap:Body>
    <GetLivre>
      <Id>3</Id>
    </GetLivre>
  </soap:Body>
</soap:Envelope>
Encore très présent dans les banques, les assurances et les administrations.
Si un jour on vous confie une API SOAP, ne paniquez pas : c'est verbeux, mais c'est bien documenté par nature.
GraphQL
Une seule URL, et le client décrit exactement les champs qu'il veut. Créé par Facebook en 2015.
query {
  livre(id: 3) {
    titre
    auteur
  }
}
Pratique quand les besoins du front varient beaucoup. Plus complexe à mettre en cache et à sécuriser.
gRPC
Appels de fonctions à distance très performants, en binaire (Protocol Buffers) sur HTTP/2. Créé par Google.
service Bibliotheque {
  rpc GetLivre (LivreRequest) returns (Livre);
}
Surtout utilisé entre microservices, rarement exposé au navigateur.
WebSocket
Une connexion qui reste ouverte dans les deux sens. Le serveur peut envoyer des messages quand il veut : chat, jeux, cours de bourse, notifications en direct.
Webhooks
L'inverse d'une API classique : « ne nous appelez pas, on vous appellera ». Vous donnez une URL au service, et c'est lui qui vous envoie une requête HTTP quand un événement se produit (paiement reçu, commit poussé…).
Comparatif
| Format | Transport | Cas d'usage typique | |
|---|---|---|---|
| REST | JSON (souvent) | HTTP | API publiques, back de SPA et d'apps mobiles |
| SOAP | XML | HTTP (POST) | Systèmes d'entreprise historiques |
| GraphQL | JSON | HTTP (une seule URL) | Fronts complexes, données très liées |
| gRPC | Binaire (Protobuf) | HTTP/2 | Communication entre microservices |
| WebSocket | Libre | Connexion persistante | Temps réel |
| Webhooks | JSON (souvent) | HTTP, dans l'autre sens | Notification d'événements |
TP : Trouver l'API cachée d'un site
Objectif
Beaucoup de sites modernes sont des SPA : le navigateur charge une page quasi vide, puis récupère tout son contenu en appelant une API. Cette API n'est pas documentée publiquement, mais elle est sous vos yeux.
En groupe, vous allez découvrir l'API cachée d'un site réel, puis rejouer une de ses requêtes hors du navigateur avec curl.
On observe, on ne casse rien : uniquement des requêtes de lecture, à la main, sans boucle ni script. Les conditions d'utilisation de certains sites interdisent l'usage automatisé de leurs API internes.
Consignes
1 - Choisir un site
Choisissez un site parmi la liste, ou proposez-en un autre au formateur.
- Plutôt faciles : Wikipédia (barre de recherche), Open Food Facts, Steam (suggestions de recherche), Deezer (recherche), adresse.data.gouv.fr
- Plus coriaces : Leboncoin, SNCF Connect
2 - Observer le trafic
- Ouvrez les DevTools (
F12), onglet Réseau (Network). - Filtrez sur Fetch/XHR pour ne garder que les appels d'API.
- Utilisez le site normalement (recherche, filtres, pagination…) et regardez quelles requêtes apparaissent.
Cochez Preserve log pour ne pas perdre les requêtes quand la page change.
3 - Analyser une requête
Pour une requête intéressante, relevez :
- l'URL et la méthode HTTP ;
- les paramètres (dans l'URL ou dans le body) ;
- les headers qui semblent importants ;
- le code de statut et le format de la réponse (onglets Aperçu et Réponse).
4 - Rejouer la requête avec curl
- Clic droit sur la requête → Copier → Copier en tant que cURL.
- Collez la commande dans un terminal et exécutez-la : vous devez obtenir la même réponse.
- Supprimez les headers un par un et relancez à chaque fois. Gardez la commande la plus courte qui fonctionne encore.
- Modifiez un paramètre (le terme recherché, la page…) et vérifiez que la réponse change.
Si la requête rejouée est refusée (403, captcha…), le site est sans doute protégé par un anti-bot. Ce n'est pas un échec : notez quels headers ou cookies semblent nécessaires et pourquoi.
Résultat attendu
Une fiche par groupe, présentée à l'oral en quelques minutes :
- le site choisi et ce que fait la requête étudiée ;
- l'URL, la méthode et les paramètres ;
- un extrait de la réponse (format, structure) ;
- la commande curl minimale qui fonctionne, ou l'explication de ce qui bloque ;
- votre avis : cette API est-elle « propre » ? Les URL sont-elles lisibles ?
Chapitre 2 - Les principes REST
Les 6 contraintes REST
REST (REpresentational State Transfer) n'est ni un protocole ni une norme : c'est un style d'architecture, décrit par Roy Fielding en 2000. Une API est dite RESTful quand elle respecte ses contraintes.
Pour les illustrer, on reprend l'analogie du restaurant, et l'API publique de GitHub.
REST est décrit par 6 contraintes : article Wikipédia.
1 - Client-serveur
Le client (l'interface) et le serveur (les données, la logique) sont séparés et évoluent indépendamment. Tant que le contrat est respecté, on peut refaire tout le front sans toucher au back, ou l'inverse.
Au restaurant : vous ne passez pas en cuisine. Le chef peut changer de four sans que vous changiez votre façon de commander.
2 - Sans état (stateless)
Chaque requête contient tout ce qu'il faut pour être traitée. Le serveur ne garde aucun contexte de session entre deux requêtes.
curl -H "Authorization: Bearer mon-token" https://api.github.com/userAu restaurant : le serveur a une mémoire de poisson rouge. Rappelez-lui votre numéro de table à chaque commande.
Avantage : n'importe quel serveur peut répondre à n'importe quelle requête, ce qui facilite la montée en charge.
3 - Cache
Les réponses indiquent si elles peuvent être mises en cache, et combien de temps. Le client (ou un proxy) peut alors réutiliser une réponse sans redemander.
curl -i https://api.github.com/users/thibaudfrichetHTTP/2 200
cache-control: public, max-age=60, s-maxage=60Ici, GitHub autorise à garder la réponse 60 secondes.
Au restaurant : la carte ne change pas toutes les 5 minutes. Pas besoin de la redemander à chaque fois.
4 - Interface uniforme
La contrainte centrale de REST. Toutes les ressources se manipulent de la même manière :
- chaque ressource est identifiée par une URI :
/users/thibaudfrichet,/repos/thibaudfrichet/homelab-agent; - on la manipule à travers ses représentations (JSON, XML…) ;
- les messages sont autodescriptifs : méthode,
Content-Type, code de statut ; - les réponses contiennent des liens vers les actions possibles : c'est HATEOAS, vu au chapitre 9.
Conséquence : quand on connaît une API REST, on sait déjà à moitié utiliser toutes les autres.
5 - Système en couches
Le client ne sait pas (et n'a pas besoin de savoir) s'il parle directement au serveur ou à un intermédiaire : reverse proxy, load balancer, CDN, cache, passerelle d'API…
6 - Code à la demande (facultatif)
Le serveur peut envoyer du code exécutable au client, typiquement du JavaScript. C'est la seule contrainte facultative, et la moins utilisée dans les API.
La plupart des API qui se disent « REST » n'en respectent pas toutes les contraintes, en particulier HATEOAS. Fielding s'en plaint publiquement depuis 2008. Dans la pratique, « API REST » veut souvent dire « API HTTP + JSON avec des URL propres ».
Ressources, URI et représentations
Les ressources
Une ressource est tout ce qui mérite d'avoir un nom et une adresse : un utilisateur, un dépôt, un livre, un emprunt, le profil de l'utilisateur connecté…
Une ressource n'est pas une table SQL. /user sur GitHub est une ressource (« moi »), alors qu'elle correspond à une ligne parmi d'autres de la table des utilisateurs. À l'inverse, un emprunt de livre peut réunir des données de plusieurs tables.
Les URI
Chaque ressource est identifiée par une URI (Uniform Resource Identifier). L'API de GitHub en donne de bons exemples :
| Type | Exemple | Signification |
|---|---|---|
| Collection | /users |
Tous les utilisateurs |
| Élément | /users/thibaudfrichet |
L'utilisateur thibaudfrichet |
| Sous-collection | /users/thibaudfrichet/repos |
Les dépôts de thibaudfrichet |
| Singleton | /user |
L'utilisateur connecté (il n'y en a qu'un) |
L'URI désigne quoi. C'est la méthode HTTP qui dit quoi faire avec. Les règles de nommage sont détaillées au chapitre 5.
GET    /v1/livres/3              ✅ lire le livre 3
DELETE /v1/livres/3              ✅ supprimer le livre 3
GET    /v1/deleteLivre?id=3      ❌ un verbe dans l'URL
Les représentations
Le client ne reçoit jamais la ressource elle-même, mais une représentation de son état à un instant donné. Une même ressource peut avoir plusieurs représentations.
Le client indique ce qu'il veut avec le header Accept. C'est la négociation de contenu. Exemple avec l'API d'une bibliothèque :
En JSON :
curl -H "Accept: application/json" https://api.biblio.example/v1/livres/3{"id": 3, "titre": "Le Petit Prince", "auteur": "Antoine de Saint-Exupéry"}En XML :
curl -H "Accept: application/xml" https://api.biblio.example/v1/livres/3<livre id="3">
<titre>Le Petit Prince</titre>
<auteur>Antoine de Saint-Exupéry</auteur>
</livre>Et si le format demandé n'existe pas, le serveur répond 406 Not Acceptable :
curl -i -H "Accept: image/png" https://api.biblio.example/v1/livres/3HTTP/1.1 406 Not AcceptableUne représentation, c'est comme une photo : la même personne peut être en couleur ou en noir et blanc, en portrait ou en miniature. La personne, elle, ne change pas.
Dans l'autre sens, c'est le header Content-Type qui indique le format du body que le client envoie.
Les verbes HTTP
Les verbes (ou méthodes) HTTP indiquent l'action à effectuer sur la ressource désignée par l'URI.
Tous les exemples de cette page fonctionnent avec JSONPlaceholder, une fausse API de blog : essayez-les avec curl -i !
JSONPlaceholder fait semblant : il répond comme si l'opération avait réussi, mais rien n'est réellement créé ni supprimé. Parfait pour s'entraîner sans rien casser.
Les verbes à connaître
| Verbe | Rôle | Exemple | Body |
|---|---|---|---|
GET |
Lire | GET /posts |
Non |
POST |
Créer dans une collection, ou déclencher un traitement | POST /posts |
Oui |
PUT |
Remplacer entièrement (ou créer à une URI connue) | PUT /posts/1 |
Oui |
PATCH |
Modifier partiellement | PATCH /posts/1 |
Oui |
DELETE |
Supprimer | DELETE /posts/1 |
Non |
HEAD |
Comme GET, mais seulement les headers | HEAD /posts |
Non |
OPTIONS |
Lister les méthodes autorisées | OPTIONS /posts/1 |
Non |
curl -i https://jsonplaceholder.typicode.com/posts/1
curl -i -X DELETE https://jsonplaceholder.typicode.com/posts/1
curl -I https://jsonplaceholder.typicode.com/posts     # -I envoie un HEAD
curl -i -X OPTIONS https://jsonplaceholder.typicode.com/posts/1
En principe, OPTIONS renvoie la liste des méthodes dans le header Allow. JSONPlaceholder la renvoie dans Access-Control-Allow-Methods, un header lié à CORS (voir chapitre 8).
Sûr et réexécutable
- Sûr (safe) : la requête ne modifie rien sur le serveur. On peut l'envoyer sans risque.
- Réexécutable : envoyer la requête 1 fois ou 10 fois laisse le serveur dans le même état. On peut la renvoyer sans risque si le réseau a coupé.
| Verbe | Sûr | Réexécutable |
|---|---|---|
GET, HEAD, OPTIONS |
✅ | ✅ |
PUT |
❌ | ✅ |
DELETE |
❌ | ✅ |
POST |
❌ | ❌ |
PATCH |
❌ | ❌ (pas garanti) |
Cliquer 3 fois sur « Payer » envoie 3 POST : 3 paiements (et un client furieux).
Supprimer 3 fois l'article 1 avec DELETE, c'est toujours un seul article supprimé.
Réexécutable ne veut pas dire « même réponse » : le premier DELETE renvoie 204, le second peut renvoyer 404. Ce qui compte, c'est l'état du serveur.
PUT ou PATCH ?
PUT remplace toute la ressource : les champs absents sont perdus.
curl -i -X PUT https://jsonplaceholder.typicode.com/posts/1 \
  -H "Content-Type: application/json" \
  -d '{"id": 1, "userId": 1, "title": "Nouveau titre", "body": "Nouveau contenu"}'
PATCH ne modifie que les champs envoyés.
curl -i -X PATCH https://jsonplaceholder.typicode.com/posts/1 \
  -H "Content-Type: application/json" \
  -d '{"title": "Nouveau titre"}'
Avec un PUT qui ne contiendrait que {"title": "Nouveau titre"}, l'article perdrait son contenu.
Ne jamais modifier avec GET
Un GET doit rester sûr. Les navigateurs, les robots d'indexation et les outils de préchargement suivent les liens sans demander la permission.
❌ GET    /api/article/delete?id=1
✅ DELETE /posts/1
En 2005, le Google Web Accelerator préchargeait les liens des pages visitées… y compris les liens « supprimer » de certaines interfaces d'administration.
https://www.lemondeinformatique.fr/actualites/lire-retour-au-stand-pour-google-web-accelerator-8289.html
Les codes de statut
Le code de statut est la première chose qu'un client regarde. Un bon code évite au client de devoir lire le body pour savoir si ça a marché.
Une API qui répond toujours 200 OK avec {"error": true} dans le body oblige chaque client à réinventer la gestion d'erreurs. Le code de statut est fait pour ça : utilisez-le.
Les exemples ci-dessous concernent l'API d'une bibliothèque en ligne : des livres, des membres, des emprunts.
2xx - Succès
| Code | Quand l'utiliser | Exemple |
|---|---|---|
200 OK | Succès avec un body | GET /v1/livres |
201 Created | Ressource créée. Ajouter le header Location | POST /v1/emprunts |
204 No Content | Succès sans body | DELETE /v1/emprunts/42 |
3xx - Redirection
| Code | Quand l'utiliser |
|---|---|
301 Moved Permanently | La ressource a changé d'adresse définitivement |
304 Not Modified | La version en cache du client est toujours bonne |
4xx - Erreur du client
| Code | Quand l'utiliser | Exemple |
|---|---|---|
400 Bad Request | Requête mal formée | Un body qui n'est pas du JSON valide |
401 Unauthorized | Pas authentifié, ou authentification invalide | GET /v1/me sans token |
403 Forbidden | Authentifié, mais pas autorisé | Un membre qui veut supprimer un livre du catalogue |
404 Not Found | La ressource n'existe pas | GET /v1/livres/999999 |
405 Method Not Allowed | Méthode non supportée sur cette URI. Ajouter le header Allow | DELETE /v1/livres (supprimer tout le catalogue) |
406 Not Acceptable | Format demandé dans Accept indisponible | Accept: image/png |
409 Conflict | Conflit avec l'état actuel de la ressource | Emprunter un livre déjà emprunté |
418 I'm a teapot | Le serveur est une théière (RFC 2324, poisson d'avril de 1998) | Demander un café à une théière |
422 Unprocessable Content | Requête bien formée mais données invalides | Une date de retour antérieure à la date d'emprunt |
429 Too Many Requests | Trop de requêtes. Ajouter le header Retry-After | Un script qui interroge l'API en boucle |
5xx - Erreur du serveur
| Code | Quand l'utiliser |
|---|---|
500 Internal Server Error | Bug côté serveur. Ne jamais le renvoyer volontairement |
502 Bad Gateway | Un intermédiaire n'a pas obtenu de réponse valide du serveur |
503 Service Unavailable | Serveur indisponible (maintenance, surcharge) |
Les pièges classiques
- 401 ou 403 ?
401: « je ne sais pas qui tu es ».403: « je sais qui tu es, et c'est non ». - 400 ou 422 ?
400: je n'arrive pas à lire ta requête.422: je l'ai lue, mais son contenu n'est pas valide. FastAPI renvoie422par défaut pour les erreurs de validation. - 404 ou 403 ? Pour une ressource qui appartient à quelqu'un d'autre, répondre
404évite de révéler qu'elle existe. On en reparle au chapitre 8.
La liste complète est sur MDN. Et pour les retenir : http.cat.
Le modèle de maturité de Richardson
En 2008, Leonard Richardson propose un modèle en 4 niveaux pour mesurer à quel point une API exploite le web. Chaque niveau ajoute un des principes REST.
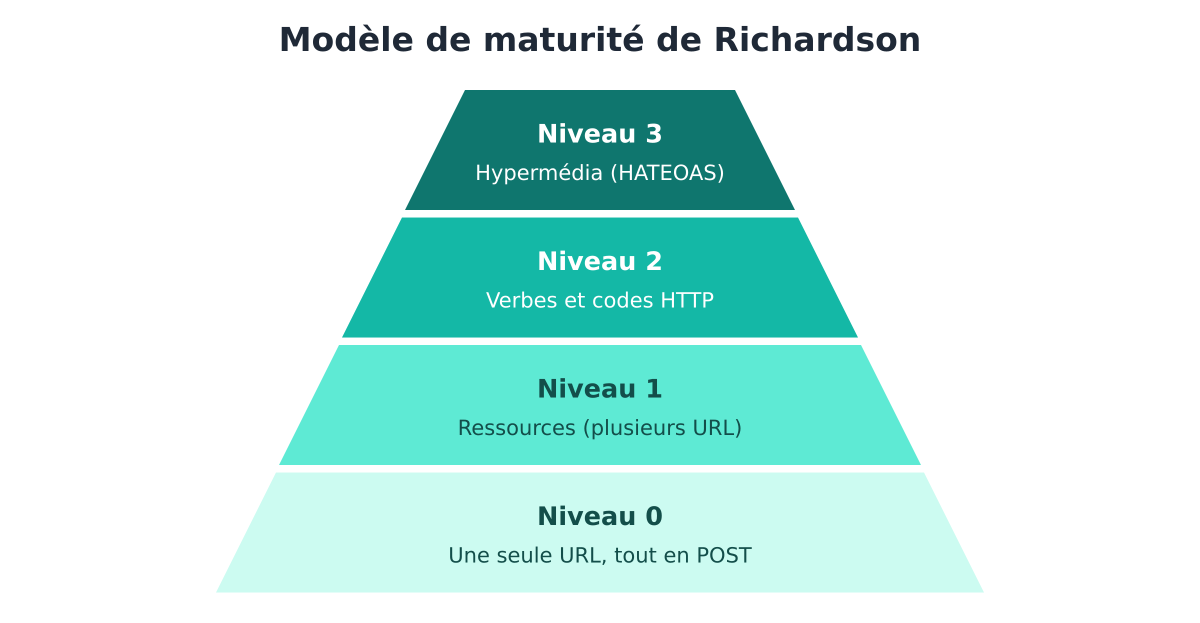
Fil conducteur : dans l'API d'une bibliothèque, annuler la réservation 42.
Niveau 0 - Le marécage du POX (Plain Old XML)
Une seule URL, une seule méthode (POST), et l'action est décrite dans le body. HTTP ne sert que de tuyau. C'est le cas de SOAP et de XML-RPC (POX : Plain Old XML).
POST /api
Content-Type: application/json

{"action": "cancelReservation", "reservationId": 42}
HTTP/1.1 200 OK
{"success": false, "error": "Livre déjà retiré"}Niveau 1 - Les ressources
Chaque ressource a sa propre URL, mais on utilise encore POST pour tout, avec des verbes dans les URL.
POST /api/reservations/42/cancelNiveau 2 - Les verbes et codes HTTP
On utilise la bonne méthode HTTP pour chaque action, et les bons codes de statut. C'est le niveau de la grande majorité des API « REST ».
DELETE /v1/reservations/42HTTP/1.1 409 ConflictNiveau 3 - Les contrôles hypermédias
Les réponses contiennent des liens vers les actions possibles. Le client n'a plus besoin de deviner les URL : il suit les liens. C'est HATEOAS.
{
  "id": 42,
  "status": "waiting",
  "_links": {
    "self":   {"href": "/v1/reservations/42"},
    "cancel": {"href": "/v1/reservations/42", "method": "DELETE"},
    "book":   {"href": "/v1/livres/3"}
  }
}
Si le livre a déjà été retiré, le lien cancel n'apparaît plus : le client sait qu'il ne peut plus annuler, sans connaître les règles métier.
Selon Fielding, seul le niveau 3 est vraiment REST. On y revient en détail au chapitre 9.
Chapitre 3 - Outils et fil rouge
Bienvenue au bar API-ritif 🍹
Tout au long de ce cours, nous allons fréquenter un établissement très particulier : API-ritif, le bar de l'école de dev. On n'y entre pas par la porte, mais par HTTP.
L'adresse exacte du bar est donnée en cours.
Consommation responsable : les cocktails d'API-ritif sont 100 % virtuels.
L'abus de requêtes est sanctionné par le barman (voir 429).
La carte
| Cocktail | Description du barman |
|---|---|
| Hello World | Sans alcool. Le premier de tout développeur. |
| Null Pointer Mojito | Sans alcool : contient null alcool. |
| Segfault Sunrise | Un classique. Plante rarement, mais sans prévenir. |
| Pull Request Colada | Doux et crémeux. Nécessite deux approbations. |
| Blue Screen Lagoon | Bleu. Très bleu. |
| Java Martini | Un espresso martini. Long à démarrer, puis très efficace. |
| Merge Conflict | Deux alcools qui ne s'entendent pas. À résoudre à la main. |
| Kernel Panic | Le plus fort de la carte. Redémarrage conseillé après. |
| 404 Spritz | Introuvable, comme son nom l'indique. |
| Sudo Rhum | Pour ceux qui ont les droits. |
| Infinite Loop | On en reprend un, puis un autre, puis un autre… |
Le barman murmure qu'il existe d'autres cocktails, qui ne figurent pas sur la première page de la carte…
Les règles de la maison
- Toutes les routes commencent par
/v1. - Le bar parle JSON. Pensez au header
Content-Type: application/jsonquand vous envoyez des données. - Les listes sont paginées : paramètres
?page=et?per_page=. - Certaines routes demandent d'être client du bar : envoyez votre clé dans le header
X-API-Key. - Les erreurs sont renvoyées au format
application/problem+json: lisez-les, elles sont souvent bavardes. - Le barman n'est pas une machine : trop de requêtes d'un coup et il vous demande de patienter.
Les principales ressources
| Ressource | Description |
|---|---|
/v1/ |
L'accueil du bar |
/v1/customers |
Les clients (inscription) |
/v1/me |
Votre profil |
/v1/cocktails |
La carte |
/v1/cocktails/{id}/reviews |
Les avis sur un cocktail |
/v1/orders |
Vos commandes |
La documentation complète de l'API (le contrat OpenAPI) sera étudiée au chapitre 6. D'ici là, explorez !
La vie d'une commande
Une commande ne reste pas figée : elle avance toute seule dans le temps.
pending ──▶ preparing ──▶ ready ──▶ served
   │
   └──▶ cancelled   (uniquement tant qu'elle est pending)
Comme dans un vrai bar : une fois que le barman a commencé à préparer la commande, il est trop tard pour annuler !
curl, Bruno et Postman
Pour parler à une API, pas besoin d'écrire du code : des outils permettent d'envoyer des requêtes HTTP à la main.
curl
curl est l'outil en ligne de commande de référence. Il est installé par défaut sur Linux, macOS et Windows 10+.
curl http://api-ritif.portlatch.com/v1/cocktailsLes options utiles
| Option | Rôle |
|---|---|
-i |
Affiche les headers de la réponse |
-v |
Mode verbeux : affiche toute la requête et toute la réponse |
-X METHODE |
Choisit la méthode HTTP (-X DELETE) |
-H "Nom: valeur" |
Ajoute un header |
-d '...' |
Envoie un body (et passe en POST par défaut) |
--json '...' |
Envoie du JSON, avec les headers Content-Type et Accept adaptés |
-s |
Mode silencieux (masque la barre de progression) |
Exemples
# Lire les headers de la réponse
curl -i http://api-ritif.portlatch.com/v1/cocktails/3

# Envoyer du JSON
curl -i -X POST http://api-ritif.portlatch.com/v1/orders \
  -H "Content-Type: application/json" \
  -H "X-API-Key: votre-cle" \
  -d '{"cocktail_id": 3}'

# La même chose, en plus court
curl -i http://api-ritif.portlatch.com/v1/orders \
  -H "X-API-Key: votre-cle" \
  --json '{"cocktail_id": 3}'

# Supprimer
curl -i -X DELETE http://api-ritif.portlatch.com/v1/orders/42 -H "X-API-Key: votre-cle"
Pour rendre le JSON lisible, passez la réponse dans un formateur : curl -s ... | python3 -m json.tool ou curl -s ... | jq.
Sous Windows PowerShell, curl peut être un alias vers Invoke-WebRequest, qui n'a pas les mêmes options. Utilisez curl.exe, ou Git Bash.
Plutôt que de copier votre clé dans chaque commande, stockez-la dans une variable : export KEY=votre-cle, puis -H "X-API-Key: $KEY".
Bruno
Bruno est un client d'API graphique, open source et sans compte. On y enregistre ses requêtes dans des collections.
Sa particularité : une collection est un dossier de fichiers texte. On peut donc la versionner dans git et la partager avec son équipe comme du code.
Prise en main
- Installez Bruno depuis usebruno.com/downloads.
- Créez une collection
api-ritifdans un dossier de votre choix. - Créez un environnement avec deux variables :
baseUrl=http://api-ritif.portlatch.com/v1etapiKey= votre clé. - Créez une requête
GET {{baseUrl}}/cocktailset envoyez-la. - Dans l'onglet Headers d'une requête, ajoutez
X-API-Key: {{apiKey}}.
Et Postman ?
Postman est le client d'API le plus connu, et vous le croiserez sûrement en entreprise. Il fonctionne sur le même principe que Bruno.
On ne l'utilise pas dans ce cours : il demande un compte, et stocke les collections dans son cloud plutôt que dans votre dépôt git.
TP : La chasse au trésor
Objectif
Le barman d'API-ritif a caché un trésor quelque part dans son API. Pour le trouver, il faudra lire attentivement chaque réponse : codes de statut, headers, body… Rien n'est là par hasard.
Chaque étape franchie vous donne un flag : il se trouve dans le header de la réponse (X-Flag). Il y a 9 flags à activer.
TP noté, utilisation de curl ou bruno au choix
Consignes
Règles du jeu
Inscrivez-vous avec le pseudo prenom-nom, sans accents ni espaces (ex. : helene-dupre). C'est lui qui permet au formateur de vous noter : un pseudo fantaisiste, c'est un TP sans note.
- Chaque réponse de l'API contient l'indice qui mène à l'étape suivante (header
X-Hint). Lisez tout, y compris les headers (curl -i). - Quand vous franchissez une étape, la réponse contient son flag dans le header
X-Flag, pas dans le body. Sanscurl -i, vous ne verrez ni les flags ni les indices. - Dès que vous avez une clé d'API, soumettez chaque flag trouvé :
curl -i http://api-ritif.portlatch.com/v1/hunt/flag \ -H "X-API-Key: $KEY" \ --json '{"code": "RITIF-XXXX-XXXXXXXX"}' - Les flags se valident dans l'ordre, et ne s'échangent pas : chaque flag (sauf le premier) est lié à votre clé.
Bloqué ? Relisez la page des codes de statut et celle des verbes HTTP. Un message d'erreur est souvent un indice.
Les 9 flags à activer
Chaque étape ci-dessous renvoie un flag dans le header de la réponse. Soumettez-les dans cet ordre :
- Lire les headers de l'accueil du bar.
- Vous inscrire comme client du bar.
- Vous présenter au barman : d'abord sans clé, puis avec.
- Trouver le cocktail secret de la carte et le consulter.
- Commander un thé.
- Commander un cocktail et suivre sa commande jusqu'à ce qu'elle soit prête.
- Annuler une commande à temps. Découvrez au passage ce que répond
OPTIONS. - Obtenir un cocktail en XML.
- Faire déborder le barman jusqu'au
429, respecter le délai demandé, puis refaire une requête.
Point de départ
Tout commence à l'accueil du bar :
curl -i http://api-ritif.portlatch.com/v1/Le reste, c'est à vous de le trouver. Santé ! 🍹
Chapitre 4 - Consommer une API en code
Appeler une API avec requests
curl et Bruno, c'est bien pour explorer. Mais pour automatiser, il faut appeler l'API depuis du code. Les exemples sont donnés en Python, avec la bibliothèque requests.
Prérequis
Python 3 et la bibliothèque requests : pip install requests.
Votre clé d'API n'a rien à faire dans le code (ni dans git). Passez-la par une variable d'environnement : export API_KEY=votre-cle.
Lire une ressource
import requests

BASE = "http://api-ritif.portlatch.com/v1"

res = requests.get(BASE + "/cocktails/3")
cocktail = res.json()
print(res.status_code, cocktail["name"])
Paramètres de query
res = requests.get(BASE + "/cocktails", params={"alcohol_free": "true", "per_page": 5})Envoyer du JSON avec un header
import os

res = requests.post(
    BASE + "/orders",
    json={"cocktail_id": 3},
    headers={"X-API-Key": os.environ["API_KEY"]},
)
print(res.status_code, res.headers.get("Location"))
Avec json=, requests sérialise le body et ajoute le Content-Type tout seul.
Le piège : les erreurs HTTP
requests ne lève pas d'erreur sur un 404 ou un 500 : il ne le fait que si le réseau est coupé. Votre code continue donc tranquillement… avec une réponse d'erreur.
res = requests.get(BASE + "/cocktails/999")
res.raise_for_status()  # lève une exception si le code est 4xx ou 5xx
En résumé
Python (requests) | |
|---|---|
| Code de statut | res.status_code |
| Succès (2xx) ? | res.ok |
| Header | res.headers["Location"] |
| Body JSON | res.json() |
| Envoyer du JSON | json=... |
| Lever une erreur | res.raise_for_status() |
Pagination, erreurs, 401 et 429
Un script qui marche sur la première page, avec un serveur de bonne humeur, c'est facile. Un script robuste doit aussi gérer la pagination, les erreurs et un serveur qui demande de ralentir.
La pagination
Une API ne renvoie jamais une liste de 10 000 éléments d'un coup : elle découpe en pages. Sur API-ritif, une liste ressemble à ceci :
{
  "items": [ {"id": 1, "name": "Hello World"}, ... ],
  "page": 1,
  "per_page": 5,
  "total": 13,
  "_links": {
    "self":  {"href": "/v1/cocktails?page=1&per_page=5"},
    "next":  {"href": "/v1/cocktails?page=2&per_page=5"},
    "last":  {"href": "/v1/cocktails?page=3&per_page=5"}
  }
}
La méthode la plus fiable : suivre le lien next jusqu'à ce qu'il n'y en ait plus. Pas besoin de calculer les numéros de page.
import pprint
from urllib.parse import urljoin

def get_all(path, headers=None):
    items = []
    url = urljoin(BASE, path)
    while url:
        res = requests.get(url, headers=headers)
        res.raise_for_status()
        data = res.json()
        items.extend(data["items"])
        next_link = data["_links"].get("next")
        url = urljoin(BASE, next_link["href"]) if next_link else None
    return items

cocktails = get_all("/v1/cocktails")

pprint.pp(cocktails)
Les liens sont relatifs (/v1/...) : urljoin() les combine avec l'adresse du serveur.
Lire les erreurs
API-ritif renvoie ses erreurs au format application/problem+json (détaillé au chapitre 5). Le champ detail est fait pour être affiché :
{
  "type": "https://api-ritif.example/problems/out-of-stock",
  "title": "Rupture de stock",
  "status": 409,
  "detail": "Le 404 Spritz est introuvable. Comme d'habitude."
}
if not res.ok:
problem = res.json()
print(problem["status"], problem["title"], ":", problem["detail"])401 : l'authentification a échoué
Un 401 signifie que le serveur ne vous reconnaît pas : clé absente, clé fausse, ou token expiré. Certains tokens ne vivent que quelques minutes (c'est le cas des JWT d'API-ritif, voir chapitre 8).
Réaction attendue d'un client :
- clé absente ou fausse : inutile d'insister, il faut corriger la configuration ;
- token expiré : en redemander un nouveau, puis rejouer la requête une fois.
429 : le serveur demande de ralentir
Pour se protéger, une API limite le nombre de requêtes par client (rate limiting). Au-delà, elle répond 429 Too Many Requests, souvent avec un header Retry-After qui indique combien de secondes attendre.
HTTP/1.1 429 Too Many Requests
Retry-After: 10
Content-Type: application/problem+json

{"title": "Too Many Requests", "status": 429, "detail": "Le barman est débordé, reviens dans 10 s"}
Un bon client attend, puis réessaie :
import time

def polite_get(url, **kwargs):
    while True:
        res = requests.get(url, **kwargs)
        if res.status_code != 429:
            return res
        wait = int(res.headers.get("Retry-After", 1))
        print("429 reçu, pause de", wait, "s")
        time.sleep(wait)
Sans Retry-After, la bonne pratique est le backoff exponentiel : attendre 1 s, puis 2 s, puis 4 s, puis 8 s… Le serveur respire, et vous finissez par passer.
Réessayer immédiatement en boucle après un 429, c'est comme klaxonner dans un embouteillage : ça n'avance pas plus vite, et tout le monde vous déteste.
Les machines consomment aussi vos API
Jusqu'ici, les clients de nos API étaient des programmes écrits par des humains. Depuis l'arrivée des LLM, un nouveau type de client apparaît : l'IA elle-même.
Un LLM qui utilise des outils
Un modèle de langage ne fait que produire du texte. Pour agir sur le monde (lire une météo, créer un ticket, allumer une lampe), on lui donne des outils : des fonctions décrites par un nom, une description et des paramètres. Le modèle décide quand les appeler, et le programme qui l'héberge exécute l'appel.
Utilisateur ──▶ LLM ──▶ « appelle l'outil get_weather(ville="Lyon") »
                              │
                              ▼
                   Programme hôte ──▶ GET https://api.meteo.example/v1/previsions?ville=Lyon
                              │
                              ▼
                LLM ◀── {"temperature": 14, "ciel": "nuageux"}
                 │
                 ▼
Utilisateur ◀── « Il fait 14 °C à Lyon, prenez un parapluie. »
Derrière la plupart des outils… il y a une API.
MCP
Le Model Context Protocol (MCP), publié par Anthropic fin 2024 et adopté depuis par la plupart des acteurs, standardise cette mécanique. Un serveur MCP expose des outils, et n'importe quel assistant compatible (Claude, ChatGPT, Copilot, des éditeurs de code…) peut les utiliser.
Un serveur MCP est souvent une simple surcouche d'une API existante : il traduit les outils en appels HTTP.
L'API, c'est le MCP du pauvre
Un agent IA capable d'exécuter des commandes (comme Claude Code) n'a même pas besoin de MCP : si on lui donne une URL, une clé et une documentation, il sait écrire les requêtes curl lui-même. À condition que l'API soit compréhensible.
Ce qui aide une IA à utiliser votre API, c'est exactement ce qui aide un développeur :
- des ressources et des routes bien nommées ;
- des codes de statut justes, plutôt qu'un
200pour tout ; - des messages d'erreur explicites, qui disent quoi corriger ;
- une documentation à jour, avec des descriptions et des exemples (OpenAPI, chapitre 6) ;
- des liens dans les réponses pour découvrir la suite (HATEOAS, chapitre 9).
Une API mal conçue fait perdre une heure à un développeur. Elle peut faire faire n'importe quoi à une IA, très vite et avec beaucoup d'assurance.
Donner une clé d'API à une IA, c'est lui donner les mêmes droits que vous. Préférez des clés limitées (lecture seule, périmètre réduit) et révocables.
TP : Script de statistiques
Objectif
Pendant la chasse au trésor, toute la promo a passé des commandes au bar. Le patron d'API-ritif veut maintenant des statistiques, et il compte sur vous.
Vous allez compléter un script Python qui récupère les données par l'API et calcule des statistiques.
Ce TP est individuel et noté.
Le fichier de départ
Copiez le code ci-dessous dans un fichier stats.py. La partie réseau est déjà écrite : la fonction get_all parcourt toutes les pages. Votre travail porte uniquement sur les données.
Le script fonctionne dès le départ : chaque question affiche None tant que vous ne l'avez pas faite. Commencez par le lancer, et regardez les deux exemples affichés en haut : ils montrent les champs d'une commande et d'un cocktail.
# TP2 - Script de statistiques sur API-ritif
#
# Lancement :
#   export API_KEY=ma-cle        (sous Windows PowerShell : $env:API_KEY="ma-cle")
#   python stats.py > resultat.txt
#
# Le script fonctionne dès le départ : chaque question affiche None
# tant que vous ne l'avez pas faite. Complétez les blocs « À FAIRE ».

import os
from urllib.parse import urljoin

import requests

BASE = "http://api-ritif.portlatch.com/v1"

# La clé est lue dans une variable d'environnement, jamais écrite dans le code.
HEADERS = {"X-API-Key": os.environ["API_KEY"]}


# =============================================================================
# FOURNI : ne pas modifier
# =============================================================================

def get_all(path):
    """Renvoie TOUS les éléments d'une liste paginée, en suivant le lien next."""
    items = []
    url = urljoin(BASE, path)
    while url:
        res = requests.get(url, headers=HEADERS)
        res.raise_for_status()
        data = res.json()
        items.extend(data["items"])
        next_link = data["_links"].get("next")
        url = urljoin(BASE, next_link["href"]) if next_link else None
    return items


orders = get_all("/v1/orders?scope=all&per_page=50")
cocktails = get_all("/v1/cocktails?per_page=50")

# Regardez bien ces deux exemples : ils montrent les champs disponibles.
print("Exemple de commande :", orders[0])
print("Exemple de cocktail :", cocktails[0])
print()


# =============================================================================
# QUESTIONS OBLIGATOIRES
# =============================================================================

# ----- Question 1 : le nombre total de commandes -----------------------------

total = None  # À FAIRE

print("Q1 - Nombre de commandes :", total)


# ----- Question 2 : le nombre de commandes par statut ------------------------
# EXEMPLE RÉSOLU : c'est le modèle pour compter, à réutiliser plus bas.
# On part d'un dictionnaire vide, et pour chaque commande on ajoute 1
# au compteur de son statut (get renvoie 0 si le statut n'est pas encore vu).

by_status = {}
for order in orders:
    status = order["status"]
    by_status[status] = by_status.get(status, 0) + 1

print("Q2 - Commandes par statut :", by_status)


# ----- Question 3 : le cocktail le plus commandé -----------------------------
# Indice 1 : comptez les commandes par cocktail, comme dans la question 2.
# Indice 2 : max(d, key=d.get) renvoie la clé du dictionnaire d
#            qui a la plus grande valeur.

most_ordered = None  # À FAIRE

print("Q3 - Cocktail le plus commandé :", most_ordered)


# ----- Question 4 : l'ardoise de la promo -------------------------------------
# Le montant total des commandes, SANS compter les commandes annulées
# (statut "cancelled").
# Indice : une variable qui commence à 0, une boucle, un if.

tab = None  # À FAIRE

print("Q4 - Ardoise de la promo :", tab, "€")


# =============================================================================
# BONUS
# =============================================================================

# ----- Bonus 1 : le client qui a passé le plus de commandes ------------------
# Indice : même principe que la question 3.

best_customer = None  # À FAIRE

print("B1 - Meilleur client :", best_customer)


# ----- Bonus 2 : la note moyenne de chaque cocktail ---------------------------
# Les avis d'un cocktail : get_all("/v1/cocktails/" + str(cocktail["id"]) + "/reviews")
# Moyenne = somme des notes / nombre de notes, arrondie au dixième avec round(x, 1).
# Attention : un cocktail peut n'avoir aucun avis (division par zéro !).

averages = None  # À FAIRE : un dictionnaire nom du cocktail -> note moyenne

print("B2 - Notes moyennes :", averages)


# ----- Bonus 3 : la part de cocktails sans alcool parmi les commandes --------
# Le champ alcohol_free est dans la carte (cocktails), pas dans les commandes.
# Résultat en pourcentage, arrondi au dixième.

alcohol_free_percent = None  # À FAIRE

print("B3 - Commandes sans alcool :", alcohol_free_percent, "%")
Consignes
1 - Questions obligatoires
- Le nombre total de commandes.
- Le nombre de commandes par statut : déjà résolue, c'est le modèle à réutiliser pour compter.
- Le cocktail le plus commandé.
- « L'ardoise » de la promo : le montant total des commandes, sans compter les commandes annulées.
2 - Bonus
- Le client qui a passé le plus de commandes.
- La note moyenne de chaque cocktail, arrondie au dixième (une requête par cocktail).
- La part de cocktails sans alcool parmi les commandes, en pourcentage.
3 - Défis (non notés)
- L'heure de pointe : la tranche de 10 minutes avec le plus de commandes.
- Un classement des cocktails par note moyenne, en n'incluant que ceux qui ont au moins 3 avis.
Contraintes
- La clé d'API est lue dans la variable d'environnement
API_KEY, jamais écrite dans le code. - Aucune donnée n'est saisie à la main : tout vient de l'API.
- Ne modifiez pas la partie « FOURNI ».
Résultat attendu
- Votre script complété (
stats.py). - Un fichier
resultat.txtcontenant sa sortie :python stats.py > resultat.txt.
Vos résultats seront comparés à ceux du formateur.
Chapitre 5 - Concevoir une API
Nommer les ressources et les routes
Une URL est la première chose qu'un développeur voit de votre API. Si elle est claire, il devine la suite. Si elle ne l'est pas, il ouvre la documentation… ou abandonne.
Les règles
Des noms, pas des verbes
L'URL désigne une ressource. L'action, c'est la méthode HTTP qui la porte.
❌ GET  /getCocktails          ✅ GET    /cocktails
❌ POST /createOrder           ✅ POST   /orders
❌ POST /deleteOrder?id=42     ✅ DELETE /orders/42
Au pluriel
Une collection contient plusieurs éléments : /cocktails et /cocktails/3, plutôt que /cocktail/3. Surtout : ne mélangez pas.
En minuscules, avec des tirets
Les URL sont sensibles à la casse : /Cocktails et /cocktails sont deux adresses différentes. On écrit tout en minuscules, et on sépare les mots par des tirets (kebab-case).
❌ /happyHours ❌ /happy_hours ✅ /happy-hoursPour les champs JSON, la convention est différente : snake_case ou camelCase, au choix, mais le même partout.
Une hiérarchie courte
Les sous-ressources expriment une appartenance : /cocktails/3/reviews se lit « les avis du cocktail 3 ». Au-delà de deux niveaux, ça devient illisible.
❌ /bars/1/customers/12/orders/42/items/3
✅ /orders/42/items/3
Pas de détails techniques
Pas d'extension (.php, .json), pas de nom de technologie, pas de nom de table. Si vous réécrivez le back en Go, les URL ne doivent pas changer.
❌ /api/v1/getCocktails.php ❌ /tbl_cocktails ✅ /v1/cocktailsUne seule langue
L'anglais est recommandé : c'est la langue de la plupart des API et des outils. Une API en français (comme la bibliothèque des chapitres 1 et 2) reste acceptable, à condition de ne jamais mélanger les deux : /livres/3/reviews, non merci.
Et les actions qui ne sont pas du CRUD ?
Annuler une commande, payer, rembourser… Ces actions ne sont pas « créer, lire, modifier, supprimer ». Plusieurs solutions, de la plus REST à la plus pragmatique :
- Changer l'état de la ressource :
PATCH /orders/42avec{"status": "cancelled"}. - Utiliser le verbe qui correspond, quand il existe : annuler une commande, c'est
DELETE /orders/42(choix d'API-ritif). - Créer une sous-ressource qui représente l'action :
POST /orders/42/paymentscrée un paiement. - En dernier recours, une route d'action :
POST /orders/42/cancel. Ce n'est pas très REST, mais c'est clair et c'est très courant.
La règle d'or : un développeur qui découvre votre API doit pouvoir deviner une URL qu'il n'a jamais vue. Si /cocktails/3/reviews existe, il s'attend à trouver /orders/42, pas /getOrderById?order=42.
Filtres, tri et pagination
Une collection peut contenir des milliers d'éléments. Le client doit pouvoir n'en demander qu'une partie, dans l'ordre qui l'intéresse. Tout passe par les paramètres de query : la ressource reste la même, on ne change que la vue.
Les filtres
Un paramètre par critère, avec le nom du champ :
GET /v1/cocktails?alcohol_free=true
GET /v1/cocktails?tag=classic&max_price=10
GET /v1/orders?status=pending
Pas de filtre dans le chemin : /cocktails/alcohol-free laisse croire qu'il s'agit d'une ressource à part, et ne se combine pas avec les autres filtres.
Le tri
Un paramètre sort avec le nom du champ. Un - devant inverse l'ordre, et on peut trier sur plusieurs champs séparés par des virgules :
GET /v1/cocktails?sort=price          prix croissant
GET /v1/cocktails?sort=-price         prix décroissant
GET /v1/cocktails?sort=-price,name    prix décroissant, puis nom
Un tri par défaut doit toujours exister (souvent par id ou par date) : sans lui, l'ordre peut changer d'une page à l'autre et des éléments apparaissent en double.
La pagination
Par numéro de page (offset)
GET /v1/cocktails?page=2&per_page=5- ✅ Simple, on peut sauter directement à la page 5.
- ❌ Si des éléments sont ajoutés pendant qu'on parcourt, on voit des doublons ou on en rate.
- ❌ Lent sur de très grosses tables (la base doit compter les lignes à sauter).
Par curseur
GET /v1/orders?limit=20
GET /v1/orders?limit=20&cursor=eyJpZCI6NDJ9
Le serveur renvoie un curseur opaque qui marque la position atteinte. C'est le choix de Stripe, Slack ou Twitter.
- ✅ Stable même si des données arrivent, et rapide.
- ❌ Impossible de sauter à une page précise.
Ce que la réponse doit contenir
Le client doit savoir où il en est et comment continuer. Deux approches, souvent combinées :
- des métadonnées et des liens dans le body ;
- le header
Link(RFC 8288), utilisé par exemple par GitHub.
{
  "items": [ ... ],
  "page": 2,
  "per_page": 5,
  "total": 13,
  "_links": {
    "self":  {"href": "/v1/cocktails?page=2&per_page=5"},
    "first": {"href": "/v1/cocktails?page=1&per_page=5"},
    "prev":  {"href": "/v1/cocktails?page=1&per_page=5"},
    "next":  {"href": "/v1/cocktails?page=3&per_page=5"},
    "last":  {"href": "/v1/cocktails?page=3&per_page=5"}
  }
}
Link: </v1/cocktails?page=3&per_page=5>; rel="next", </v1/cocktails?page=3&per_page=5>; rel="last"Fixez toujours une limite maximale à per_page. Sinon, quelqu'un finira par demander ?per_page=1000000, et votre serveur s'en souviendra.
En résumé
| Besoin | Convention |
|---|---|
| Filtrer | ?champ=valeur |
| Trier | ?sort=-champ1,champ2 |
| Paginer | ?page=&per_page= ou ?cursor=&limit= |
| Naviguer | _links et/ou header Link |
Versioning
Une API publiée a des clients que vous ne connaissez pas : des applications mobiles qui ne seront pas mises à jour avant des mois, des scripts oubliés sur un serveur, des intégrations de partenaires… Changer l'API peut tous les casser d'un coup.
Ce qui casse, ce qui ne casse pas
| ✅ Compatible (pas de nouvelle version) | ❌ Rupture (breaking change) |
|---|---|
| Ajouter une route | Supprimer ou renommer une route |
| Ajouter un champ dans une réponse | Supprimer ou renommer un champ |
| Ajouter un paramètre facultatif | Rendre un paramètre obligatoire |
| Ajouter une valeur possible à un filtre | Changer le type d'un champ ("9.5" → 9.5) |
| Changer le sens d'un code de statut |
Côté client, la règle inverse : ignorez les champs que vous ne connaissez pas. Un client qui plante parce qu'un champ a été ajouté est un client mal écrit, même si cela existe parfois.
Où mettre la version ?
Dans l'URL
GET /v1/cocktails
GET /v2/cocktails
La solution la plus répandue : visible, simple à tester avec curl, facile à router. C'est le choix d'API-ritif et la méthode recommandée dans ce cours.
Dans un header
GET /cocktails
X-API-Version: 2
Les URL restent stables, mais la version est invisible dans un navigateur ou un lien. GitHub (X-GitHub-Api-Version: 2022-11-28) et Stripe (Stripe-Version) utilisent des dates comme numéro de version.
Dans le media type
GET /cocktails
Accept: application/vnd.api-ritif.v2+json
La plus « REST » selon les puristes, puisque c'est la représentation qui change. La moins pratique au quotidien.
Faire vivre les versions
- On ne change de version que pour une rupture :
v1,v2… pas dev1.3.7dans l'URL. - On maintient l'ancienne version pendant une période annoncée.
- On prévient les clients, y compris dans les réponses elles-mêmes, avec les headers
Deprecation(la version est dépréciée) etSunset(date de fin) :
HTTP/1.1 200 OK
Deprecation: @1767225600
Sunset: Wed, 30 Jun 2027 23:59:59 GMT
Link: </v2/cocktails>; rel="successor-version"
Le meilleur versioning est celui dont on n'a jamais besoin : une API bien conçue dès le départ, et qui n'évolue que par ajouts compatibles, peut vivre des années en v1.
Les erreurs avec problem+json
Le code de statut dit qu'il y a une erreur. Le body doit dire laquelle, et comment la corriger. Plutôt que d'inventer un format par API, il existe un standard : application/problem+json.
Le format
HTTP/1.1 409 Conflict
Content-Type: application/problem+json

{
  "type": "https://api-ritif.example/problems/order-not-cancellable",
  "title": "La commande ne peut plus être annulée",
  "status": 409,
  "detail": "La commande 42 est en préparation. Le shaker tourne déjà.",
  "instance": "/v1/orders/42"
}| Champ | Rôle |
|---|---|
type |
Une URI qui identifie le type d'erreur. Idéalement, une page de documentation qui l'explique. Par défaut : about:blank. |
title |
Un résumé court, le même pour toutes les erreurs de ce type. |
status |
Le code de statut HTTP, répété pour faciliter la lecture. |
detail |
L'explication propre à cette occurrence, lisible par un humain. |
instance |
Une URI qui identifie cette occurrence précise (la ressource concernée, ou un identifiant de log). |
Tous les champs sont facultatifs, mais type, title et status sont un minimum raisonnable.
Les extensions
On peut ajouter ses propres champs. Le cas le plus courant : les erreurs de validation, avec la liste des champs en faute.
HTTP/1.1 422 Unprocessable Content
Content-Type: application/problem+json

{
  "type": "https://api-ritif.example/problems/validation-error",
  "title": "Données invalides",
  "status": 422,
  "detail": "La requête contient 2 erreurs.",
  "errors": [
    {"field": "rating", "message": "doit être compris entre 1 et 5"},
    {"field": "comment", "message": "ne doit pas dépasser 500 caractères"}
  ]
}
Le client peut afficher chaque message sous le bon champ du formulaire, sans parser une phrase.
Les bonnes pratiques
- Le même format pour toutes les erreurs de l'API, y compris les
404et les500. - Un
detailqui dit quoi corriger : « la note doit être comprise entre 1 et 5 », pas « erreur de validation ». - Jamais d'informations internes dans une erreur.
Ceci n'est pas un message d'erreur, c'est une fuite d'informations :{"error": "SQLSTATE[42S22]: Column not found: 1054 Unknown column 'prix' in /var/www/api/models/Cocktail.php line 42"}
Un attaquant y apprend votre base de données, votre langage, votre arborescence et le nom de vos colonnes. Loggez le détail côté serveur, renvoyez un message neutre au client.
Exercice : L'API du stagiaire de 2009
Objectif
En rangeant la réserve du bar, le patron d'API-ritif a retrouvé une clé USB étiquetée « API v0 — NE PAS TOUCHER — Kévin, stage 2009 ». Elle contient la documentation de l'ancienne API du bar, toujours utilisée par la vieille caisse enregistreuse.
Votre mission, en groupe : critiquer cette API et proposer une version propre.
La documentation retrouvée
=== API DU BAR - by Kevin - 2009 ===
(marche bien normalement)

GET  /getCocktails.php                  -> liste des cocktails (tous, d'un coup)
GET  /getCocktails.php?alcool=0         -> cocktails sans alcool
GET  /Cocktail?id=3                     -> un cocktail
GET  /cocktails/3                       -> un cocktail aussi (nouvelle version)
GET  /api/cocktail/delete?id=3          -> supprime un cocktail
POST /api/cocktail/updatePriceV2_final  -> change le prix (envoyer id et prix)
POST /orders/list                       -> liste des commandes
POST /addOrderNew                       -> passer commande
GET  /orders?user_id=12                 -> commandes d'un client
GET  /api/getUserPassword?user=bob      -> pour le mot de passe oublié
Quelques réponses relevées :
GET /Cocktail?id=999
HTTP/1.1 200 OK
{"error": true, "msg": "pas trouvé"}

POST /addOrderNew
HTTP/1.1 200 OK
{"error": false, "data": {"Id": 42, "prix": "9,50 €", "Date": "12/03/09"}}

GET /getCocktails.php?alcool=peut-etre
HTTP/1.1 200 OK
{"error": true, "msg": "SQLSTATE[42000]: Syntax error near 'peut-etre' in /var/www/bar/getCocktails.php line 12"}
Consignes
1 - Critiquer
Pour chaque route et chaque réponse, listez tous les problèmes que vous trouvez. Pensez à tout ce qui a été vu jusqu'ici :
- nommage des routes ;
- choix des méthodes HTTP ;
- codes de statut ;
- format des données et des erreurs ;
- pagination ;
- sécurité.
Il y a plus de problèmes que de lignes. Certains sont gênants, d'autres sont graves.
2 - Corriger
Proposez la nouvelle version de l'API sous forme de tableau : méthode, route, rôle, codes de statut possibles. Proposez aussi le format corrigé des réponses ci-dessus.
Si une route ne devrait tout simplement pas exister, dites-le et expliquez pourquoi.
3 - Migrer
La vieille caisse enregistreuse ne peut pas être mise à jour avant six mois. Comment faire cohabiter l'ancienne et la nouvelle API ?
Résultat attendu
Une restitution orale par groupe :
- les 3 problèmes que vous jugez les plus graves, et pourquoi ;
- votre tableau des nouvelles routes ;
- votre stratégie de migration.
Chapitre 6 - Documenter avec OpenAPI
Lire un contrat OpenAPI
Pendant la chasse au trésor, vous avez découvert API-ritif à tâtons, en lisant les réponses une par une. Il existe une méthode plus reposante : lire son contrat.
Qu'est-ce qu'un contrat d'API ?
Un contrat décrit tout ce qu'une API sait faire, dans un format lisible par les humains et par les machines :
- les routes et les méthodes ;
- les paramètres attendus et leur type ;
- le format des bodies envoyés et reçus ;
- les codes de statut possibles ;
- la méthode d'authentification.
Le standard est OpenAPI (anciennement Swagger), écrit en YAML ou en JSON. Ce cours utilise la version 3.1. La 3.2, sortie en 2025, est encore peu supportée par les outils.
Le contrat est la source de vérité partagée entre l'équipe front, l'équipe back, les testeurs, les partenaires… et les IA. Quand le code et le contrat ne disent pas la même chose, c'est un bug.
Ouvrir le contrat d'API-ritif
- Téléchargez le contrat :
api-ritif.openapi.yaml - Ouvrez editor.swagger.io.
- Menu File → Import file, ou copiez-collez le contenu à gauche.
À gauche, le YAML. À droite, la documentation générée.
Swagger Editor sert à lire et écrire le contrat. Pour envoyer de vraies requêtes, utilisez la documentation servie par API-ritif elle-même : http://api-ritif.portlatch.com/docs (bouton Try it out). Depuis editor.swagger.io, les requêtes seraient bloquées par le navigateur : vous comprendrez pourquoi au chapitre 8 (CORS).
Swagger Editor signale en direct les erreurs de syntaxe : c'est aussi l'outil idéal pour écrire un contrat.
Ce qu'on y lit
Un extrait, pour la route qui annule une commande :
/orders/{order_id}:
  delete:
    tags: [Commandes]
    operationId: cancelOrder
    summary: Annuler une commande
    description: Possible uniquement tant que la commande est `pending`.
    security:
      - ApiKeyAuth: []
    responses:
      '204':
        description: Commande annulée
      '401':
        $ref: '#/components/responses/Unauthorized'
      '404':
        $ref: '#/components/responses/NotFound'
      '409':
        description: La commande n'est plus annulable
Sans même connaître OpenAPI, on comprend : DELETE /orders/{order_id}, authentifié par clé d'API, répond 204 en cas de succès et 409 si c'est trop tard. Tout ce que vous avez découvert à la main pendant la chasse au trésor était écrit là.
À vous de chercher
Trouvez dans le contrat la réponse à ces questions :
- Quelles routes peut-on appeler sans être authentifié ?
- Combien de caractères peut contenir un
message_to_bartender? - Combien d'éléments une page contient-elle par défaut ? Et au maximum ?
- Quels codes de statut
POST /orderspeut-il renvoyer ? - Quels sont les statuts possibles d'une commande ?
- Quelles sont les deux façons de s'authentifier ?
Structure YAML et schémas
YAML en 30 secondes
YAML est un format de données lisible, basé sur l'indentation (des espaces, jamais de tabulations).
nom: Segfault Sunrise        # une clé et une valeur
prix: 9.5                    # un nombre
sans_alcool: false           # un booléen
tags:                        # une liste
  - classic
  - fruity
recette:                     # un objet imbriqué
  base: rhum
  dose_cl: 4
code: '404'                  # des guillemets pour forcer une chaîne
Une indentation décalée d'un espace change complètement le sens du document. Si Swagger Editor affiche une erreur incompréhensible, vérifiez d'abord l'indentation.
La structure d'un contrat
openapi: 3.1.0               # version d'OpenAPI

info:                        # présentation de l'API
  title: API-ritif
  version: 1.0.0
  description: Le bar de l'école de dev.

servers:                     # où se trouve l'API
  - url: http://api-ritif.portlatch.com/v1

paths:                       # les routes
  /cocktails: ...
  /cocktails/{cocktail_id}: ...

components:                  # les éléments réutilisables
  schemas: ...               #   formats de données
  parameters: ...            #   paramètres communs
  responses: ...             #   réponses communes
  securitySchemes: ...       #   méthodes d'authentification
Une opération
Sous chaque chemin, une clé par méthode HTTP. Chaque opération décrit ses paramètres, son body et ses réponses.
paths:
  /cocktails/{cocktail_id}/reviews:
    post:
      summary: Donner son avis sur un cocktail
      operationId: createReview
      parameters:
        - name: cocktail_id
          in: path              # path, query, header ou cookie
          required: true
          schema:
            type: integer
      requestBody:
        required: true
        content:
          application/json:
            schema:
              $ref: '#/components/schemas/ReviewCreate'
      responses:
        '201':
          description: Avis créé
          content:
            application/json:
              schema:
                $ref: '#/components/schemas/Review'
        '422':
description: Données invalidesL'operationId donne un nom unique à l'opération. Les générateurs de code s'en servent pour nommer les fonctions : choisissez-le bien.
Les schémas
Les schémas décrivent la forme des données, avec la syntaxe JSON Schema.
components:
  schemas:
    ReviewCreate:
      type: object
      required: [rating]               # champs obligatoires
      additionalProperties: false      # aucun autre champ accepté
      properties:
        rating:
          type: integer
          minimum: 1
          maximum: 5
          example: 4
        comment:
          type: string
          maxLength: 500
          example: Plante rarement, mais quel goût.

    OrderStatus:
      type: string
enum: [pending, preparing, ready, served, cancelled]| Mot-clé | Rôle |
|---|---|
type | string, integer, number, boolean, array, object, null |
required | Liste des champs obligatoires |
enum | Liste des valeurs autorisées |
minimum, maximum, minLength, maxLength, pattern | Contraintes de validation |
format | Précision : date-time, email, uri… |
example | Un exemple, affiché dans la documentation |
readOnly | Champ renvoyé par l'API, mais jamais accepté en entrée |
Ne pas se répéter : $ref
$ref fait référence à un élément défini ailleurs. Le schéma Problem, les paramètres de pagination ou la réponse 404 ne sont écrits qu'une fois dans components, puis réutilisés partout.
responses:
  '404':
    $ref: '#/components/responses/NotFound'
L'authentification
components:
  securitySchemes:
    ApiKeyAuth:
      type: apiKey
      in: header
      name: X-API-Key

paths:
  /me:
    get:
      security:
        - ApiKeyAuth: []    # cette route demande une clé
  /cocktails:
    get:
      security: []          # cette route est publique
Avec securitySchemes, le bouton Authorize de Swagger UI permet de saisir sa clé une fois pour toutes les requêtes de test.
Code-first ou design-first
Le contrat et le code doivent dire la même chose. Mais lequel écrit-on en premier ?
Code-first
On écrit le code, et le contrat est généré à partir de lui (annotations, types, décorateurs…).
C'est ce que fait FastAPI : les types Python et les modèles Pydantic suffisent à produire un contrat OpenAPI complet, disponible sur /openapi.json, avec sa documentation sur /docs.
from fastapi import FastAPI
from pydantic import BaseModel, Field

app = FastAPI(title="API-ritif")

class ReviewCreate(BaseModel):
    rating: int = Field(ge=1, le=5)
    comment: str | None = Field(default=None, max_length=500)

@app.post("/v1/cocktails/{cocktail_id}/reviews", status_code=201)
def create_review(cocktail_id: int, review: ReviewCreate):
    ...
Rien d'autre à écrire : rating apparaît dans le contrat comme un entier entre 1 et 5.
- ✅ Le contrat est toujours synchronisé avec le code.
- ✅ Rapide pour démarrer.
- ❌ Le contrat n'existe qu'une fois le code écrit : le front attend le back.
- ❌ La conception de l'API est guidée par l'implémentation, pas par les besoins du client.
Tous les frameworks n'en sont pas capables : Flask ou Express (JavaScript) ne connaissent pas les types des données. Il faut ajouter des bibliothèques et des commentaires spéciaux, souvent oubliés lors des modifications.
Design-first
On écrit d'abord le contrat, on le fait valider par ceux qui vont l'utiliser, puis on code.
- ✅ On réfléchit à l'API du point de vue de ses clients.
- ✅ Le front et le back travaillent en parallèle : le front utilise un mock généré à partir du contrat (voir chapitre 7).
- ✅ Le contrat sert à générer des tests, des clients, de la validation.
- ❌ Il faut une discipline pour garder le code conforme au contrat.
Des outils vérifient les requêtes et les réponses directement à partir du contrat, par exemple Prism en mode proxy (chapitre 7). Le contrat devient du code exécutable.
Comparatif
| Code-first | Design-first | |
|---|---|---|
| Point de départ | Le code | Le contrat |
| Synchronisation | Automatique | Discipline et outils de validation |
| Travail en parallèle | Difficile | Naturel |
| Adapté à… | Une API interne, une petite équipe, un prototype | Une API publique, plusieurs équipes, des partenaires |
Dans le TP des avis (chapitre 7), le contrat OpenAPI vous est fourni avant le code : c'est du design-first, et c'est lui qui fait foi.
Swagger UI, Redoc et Scalar
Un contrat en YAML, c'est précis mais austère. Des outils le transforment en une documentation agréable à lire, sans rien écrire de plus.
Trois outils, un même contrat
| Outil | Points forts |
|---|---|
| Swagger UI | Le classique. Chaque route est testable directement (Try it out). Intégré à FastAPI sur /docs. |
| Redoc | Une documentation en trois colonnes, très lisible, idéale pour une API publique. Lecture seule. Intégré à FastAPI sur /redoc. |
| Scalar | Le plus récent : moderne, avec un client de test intégré et des exemples de code générés dans de nombreux langages. |
Publier la documentation
Chaque outil tient en une page HTML qui charge le contrat. Placez la page à côté du fichier api-ritif.openapi.yaml.
Swagger UI
<!doctype html>
<html>
<head>
  <meta charset="utf-8">
  <link rel="stylesheet" href="https://unpkg.com/swagger-ui-dist@5/swagger-ui.css">
</head>
<body>
  <div id="swagger-ui"></div>
  <script src="https://unpkg.com/swagger-ui-dist@5/swagger-ui-bundle.js"></script>
  <script>
    SwaggerUIBundle({ url: "api-ritif.openapi.yaml", dom_id: "#swagger-ui" });
  </script>
</body>
</html>
Redoc
<!doctype html>
<html>
<head><meta charset="utf-8"></head>
<body>
  <redoc spec-url="api-ritif.openapi.yaml"></redoc>
  <script src="https://cdn.redoc.ly/redoc/latest/bundles/redoc.standalone.js"></script>
</body>
</html>
Scalar
<!doctype html>
<html>
<head><meta charset="utf-8"></head>
<body>
  <div id="app"></div>
  <script src="https://cdn.jsdelivr.net/npm/@scalar/api-reference"></script>
  <script>
    Scalar.createApiReference("#app", { url: "api-ritif.openapi.yaml" });
  </script>
</body>
</html>
Ouverte en double-cliquant (file://), la page ne pourra pas charger le contrat. Servez le dossier avec un petit serveur web : python3 -m http.server, puis ouvrez http://localhost:8000.
Ce qui fait une bonne documentation
Les outils mettent en forme. Le contenu, c'est vous qui l'écrivez dans le contrat :
- une
descriptiongénérale : à quoi sert l'API, comment s'authentifier, les limites de requêtes ; - un
summarycourt et clair pour chaque opération ; - une
descriptionpour les règles métier (« annulable uniquement tant que la commande estpending») ; - des
exampleréalistes pour chaque schéma ; - toutes les réponses d'erreur possibles, pas seulement le cas qui marche ;
- des
tagspour regrouper les routes par thème.
Le test ultime : un développeur qui n'a jamais vu votre API arrive-t-il à l'utiliser avec la doc seule, sans vous poser de question ?
Générer des clients
Un contrat OpenAPI est lisible par les machines. Elles peuvent donc écrire à votre place le code qui appelle l'API : c'est ce qu'on appelle un client ou un SDK.
Avantages :
- plus besoin d'écrire les URL, les headers et la sérialisation à la main ;
- l'autocomplétion de l'éditeur connaît toutes les routes et tous les champs ;
- quand le contrat change, on regénère, et les erreurs apparaissent dans l'éditeur plutôt qu'en production.
En Python : openapi-python-client
pipx run openapi-python-client generate --path api-ritif.openapi.yamlL'outil génère un package Python complet, avec un module par opération (nommé d'après l'operationId) :
from api_ritif_client import Client
from api_ritif_client.api.cocktails import get_cocktail

client = Client(base_url="http://api-ritif.portlatch.com/v1")
cocktail = get_cocktail.sync(client=client, cocktail_id=3)
print(cocktail.name)
Les noms exacts des modules dépendent du titre du contrat, de ses tags et de ses operationId. Consultez le README.md généré.
Pour tous les langages : openapi-generator
openapi-generator sait produire des clients (et des squelettes de serveurs) dans plus de 50 langages : Java, C#, Go, PHP, Kotlin, Swift… Il nécessite Java.
npx @openapitools/openapi-generator-cli generate \
  -i api-ritif.openapi.yaml -g php -o ./client-php
Les limites
- Le code généré n'est jamais meilleur que le contrat : un contrat approximatif donne un client approximatif.
- On ne modifie jamais le code généré à la main : il sera écrasé à la prochaine génération.
- Un contrat qui oublie de déclarer une erreur donne un client qui ne sait pas la gérer.
Les grandes API publiques (Stripe, GitHub, OpenAI…) publient leur contrat OpenAPI et génèrent ainsi une bonne partie de leurs SDK officiels.
Chapitre 7 - Exposer une API
Premiers pas avec FastAPI
Assez consommé : passons derrière le comptoir. Dans ce chapitre, on construit une API en Python avec FastAPI. C'est un framework « tout compris » : à partir de vos fonctions et de leurs types, il gère la validation des données (avec Pydantic) et génère tout seul le contrat OpenAPI et la documentation.
Installation
On crée un dossier pour le projet et un environnement virtuel (.venv) : les bibliothèques s'installent dedans, pas dans le Python du système. Choisissez votre système.
Windows (PowerShell)
mkdir mon-api; cd mon-api
py -m venv .venv
.venv\Scripts\Activate.ps1
pip install "fastapi[standard]"
Si Activate.ps1 est refusé (« l'exécution de scripts est désactivée »), lancez une fois Set-ExecutionPolicy -Scope CurrentUser RemoteSigned, puis réessayez. Dans l'invite de commandes classique (cmd), activez avec .venv\Scripts\activate.bat.
macOS
mkdir mon-api && cd mon-api
python3 -m venv .venv
source .venv/bin/activate
pip install "fastapi[standard]"
Si macOS propose d'installer les « outils de ligne de commande » au premier python3, acceptez, puis relancez la commande.
Linux
mkdir mon-api && cd mon-api
python3 -m venv .venv
source .venv/bin/activate
pip install "fastapi[standard]"
Sous Ubuntu/Debian, si python3 -m venv affiche « ensurepip is not available » : sudo apt install python3-venv, supprimez le dossier .venv raté (rm -rf .venv), puis recommencez.
Une fois l'environnement activé, l'invite commence par (.venv). Il faut le réactiver dans chaque nouveau terminal. Si fastapi : commande introuvable, ou si pip répond externally-managed-environment, c'est que l'environnement n'est pas activé.
Premier endpoint
# main.py
from fastapi import FastAPI

app = FastAPI(title="Mon API")

@app.get("/v1/health")
def health():
    return {"status": "ok"}
Lancer le serveur
# Sur le port 8000, redémarre à chaque modification du code
fastapi dev main.py
Et on teste, évidemment, avec curl :
curl -i http://localhost:8000/v1/healthHTTP/1.1 200 OK
Content-Type: application/json
{"status":"ok"}Le bonus de FastAPI
Ouvrez http://localhost:8000/docs : FastAPI a déjà généré le contrat OpenAPI et une documentation Swagger UI. Le contrat brut est sur /openapi.json, et une version Redoc sur /redoc.
Ce contrat généré est pratique, mais il décrit ce que fait le code, pas ce que le client attend. Le vôtre, vous l'avez écrit avant le code… n'est-ce pas ?
Routes, paramètres et body
On construit une mini carte de cocktails, stockée en mémoire. Elle disparaît au redémarrage du serveur : c'est volontaire, on se concentre sur HTTP.
Tout le code de cette page s'ajoute dans le même fichier main.py, celui de la page précédente. Gardez fastapi dev main.py lancé : le serveur redémarre tout seul à chaque enregistrement.
Les imports
# main.py, tout en haut : remplace la ligne from fastapi import FastAPI
from fastapi import FastAPI, HTTPException, Response
from pydantic import BaseModel
Les données
# main.py, juste sous app = FastAPI(...)
cocktails = [
    {"id": 1, "name": "Hello World", "price": 6, "alcohol_free": True},
    {"id": 2, "name": "Segfault Sunrise", "price": 9.5, "alcohol_free": False},
]
next_id = 3
Paramètres de query : lister et filtrer
GET /v1/cocktails?alcohol_free=true
# main.py, à la suite
@app.get("/v1/cocktails")
def list_cocktails(alcohol_free: bool | None = None):
    items = cocktails
    if alcohol_free is not None:
        items = [c for c in items if c["alcohol_free"] == alcohol_free]
    return {"items": items}
curl -i "localhost:8000/v1/cocktails?alcohol_free=true"
curl -i "localhost:8000/v1/cocktails?alcohol_free=peut-etre"Le premier répond 200 avec Hello World seul ; le second répond 422 : « peut-etre » n'est pas un booléen.
Dans l'URL, tout est du texte : ?alcohol_free=true arrive sous la forme de la chaîne "true". FastAPI la convertit tout seul grâce au type bool, et renvoie une erreur si la valeur n'est pas un booléen.
Paramètres de chemin : lire un élément
GET /v1/cocktails/2
# main.py, à la suite
@app.get("/v1/cocktails/{cocktail_id}")
def get_cocktail(cocktail_id: int):
    for c in cocktails:
        if c["id"] == cocktail_id:
            return c
    raise HTTPException(status_code=404, detail="Cocktail introuvable")
curl -i localhost:8000/v1/cocktails/2
curl -i localhost:8000/v1/cocktails/42200 avec Segfault Sunrise, puis 404 : ce cocktail n'existe pas.
Body : créer un élément
POST /v1/cocktails doit répondre 201 Created, avec le header Location et la ressource créée.
# main.py, à la suite
class CocktailIn(BaseModel):
    name: str
    price: float
    alcohol_free: bool = False

@app.post("/v1/cocktails", status_code=201)
def create_cocktail(cocktail: CocktailIn, response: Response):
    global next_id
    new = {"id": next_id, **cocktail.model_dump()}
    next_id += 1
    cocktails.append(new)
    response.headers["Location"] = "/v1/cocktails/" + str(new["id"])
    return new
curl -i localhost:8000/v1/cocktails --json '{"name": "Kernel Panic", "price": 12, "alcohol_free": false}'201 Created, avec le header location: /v1/cocktails/3 et le cocktail créé.
Essayez aussi d'envoyer un prix en lettres ("douze"), d'oublier le nom, ou d'envoyer un nom vide ("") : que se passe-t-il dans chaque cas ?
Ne copiez jamais le body reçu tel quel dans vos données : le client pourrait envoyer un id, un role ou n'importe quel champ que vous n'avez pas prévu. Ici, CocktailIn ne garde que les champs déclarés. Cette faille a un nom, on la reverra au chapitre 8.
Supprimer un élément
DELETE /v1/cocktails/2 répond 204 No Content, sans body.
# main.py, à la suite
@app.delete("/v1/cocktails/{cocktail_id}", status_code=204)
def delete_cocktail(cocktail_id: int):
    for i, c in enumerate(cocktails):
        if c["id"] == cocktail_id:
            cocktails.pop(i)
            return
    raise HTTPException(status_code=404, detail="Cocktail introuvable")
curl -i -X DELETE localhost:8000/v1/cocktails/2
curl -i -X DELETE localhost:8000/v1/cocktails/2204 la première fois ; 404 la seconde, puisque le cocktail n'existe plus.
Le fichier main.py complet
# main.py
from fastapi import FastAPI, HTTPException, Response
from pydantic import BaseModel

app = FastAPI(title="Mon API")

# Les données, en mémoire
cocktails = [
    {"id": 1, "name": "Hello World", "price": 6, "alcohol_free": True},
    {"id": 2, "name": "Segfault Sunrise", "price": 9.5, "alcohol_free": False},
]
next_id = 3


@app.get("/v1/health")
def health():
    return {"status": "ok"}


@app.get("/v1/cocktails")
def list_cocktails(alcohol_free: bool | None = None):
    items = cocktails
    if alcohol_free is not None:
        items = [c for c in items if c["alcohol_free"] == alcohol_free]
    return {"items": items}


@app.get("/v1/cocktails/{cocktail_id}")
def get_cocktail(cocktail_id: int):
    for c in cocktails:
        if c["id"] == cocktail_id:
            return c
    raise HTTPException(status_code=404, detail="Cocktail introuvable")


class CocktailIn(BaseModel):
    name: str
    price: float
    alcohol_free: bool = False


@app.post("/v1/cocktails", status_code=201)
def create_cocktail(cocktail: CocktailIn, response: Response):
    global next_id
    new = {"id": next_id, **cocktail.model_dump()}
    next_id += 1
    cocktails.append(new)
    response.headers["Location"] = "/v1/cocktails/" + str(new["id"])
    return new


@app.delete("/v1/cocktails/{cocktail_id}", status_code=204)
def delete_cocktail(cocktail_id: int):
    for i, c in enumerate(cocktails):
        if c["id"] == cocktail_id:
            cocktails.pop(i)
            return
raise HTTPException(status_code=404, detail="Cocktail introuvable")Validation et codes de retour
À la page précédente, FastAPI refusait déjà un prix en lettres ou un nom manquant, mais avec son propre format d'erreur. Et il acceptait un nom vide ou un prix négatif. Corrigeons tout ça.
Règle n°1 d'une API : ne jamais faire confiance au client. Tout ce qui arrive (body, paramètres, headers) doit être validé.
Un format d'erreur unique
Toutes les erreurs seront renvoyées au format application/problem+json (chapitre 5). On commence par une fonction utilitaire :
from fastapi.responses import JSONResponse

def problem(status, title, detail, **extra):
    return JSONResponse(
        {"type": "about:blank", "title": title, "status": status, "detail": detail, **extra},
        status_code=status,
        media_type="application/problem+json",
    )
Valider le body
On décrit la forme attendue dans un schéma Pydantic : longueurs, valeurs minimales, champs inconnus refusés.
from pydantic import BaseModel, ConfigDict, Field

class CocktailIn(BaseModel):
    model_config = ConfigDict(extra="forbid")   # refuse les champs inconnus
    name: str = Field(min_length=1, max_length=50)
    price: float = Field(gt=0)
    alcohol_free: bool = False

@app.post("/v1/cocktails", status_code=201)
def create_cocktail(cocktail: CocktailIn, response: Response):
    global next_id
    if any(c["name"] == cocktail.name for c in cocktails):
        return problem(409, "Conflict", "Le cocktail " + cocktail.name + " existe déjà.")
    new = {"id": next_id, **cocktail.model_dump()}
    next_id += 1
    cocktails.append(new)
    response.headers["Location"] = "/v1/cocktails/" + str(new["id"])
    return new
Quand la fonction s'exécute, cocktail a déjà été validé : il ne contient que les champs déclarés, avec des valeurs correctes. On peut l'utiliser sans risque.
Les erreurs de FastAPI au bon format
FastAPI valide tout seul, mais renvoie ses erreurs dans son propre format ({"detail": [...]}). On le remplace par des gestionnaires d'exceptions :
from http import HTTPStatus
from fastapi import Request
from fastapi.exceptions import RequestValidationError
from starlette.exceptions import HTTPException as StarletteHTTPException

@app.exception_handler(RequestValidationError)
async def on_validation_error(request: Request, exc: RequestValidationError):
    errors = [
        {"field": ".".join(str(p) for p in e["loc"][1:]), "message": e["msg"]}
        for e in exc.errors()
    ]
    return problem(422, "Données invalides", "La requête contient des erreurs.", errors=errors)

@app.exception_handler(StarletteHTTPException)
async def on_http_error(request: Request, exc: StarletteHTTPException):
    return problem(exc.status_code, HTTPStatus(exc.status_code).phrase, str(exc.detail))

@app.exception_handler(Exception)
async def on_crash(request: Request, exc: Exception):
    return problem(500, "Internal Server Error", "Le barman a fait tomber un verre. Réessayez plus tard.")
Désormais, raise HTTPException(status_code=404, detail="Cocktail introuvable") produit une réponse problem+json.
En production, une erreur 500 ne doit jamais renvoyer la stack trace au client. On la logge côté serveur, et on renvoie un message neutre.
Quel code renvoyer ?
| Situation | Code |
|---|---|
| Le body n'est pas du JSON | 400 (FastAPI renvoie 422, c'est acceptable) |
| Pas de clé, ou clé invalide | 401 |
| Clé valide, mais action interdite | 403 |
Ressource inexistante (y compris dans le chemin : /cocktails/999/reviews) | 404 |
| Conflit avec l'état actuel (doublon, état qui ne permet pas l'action) | 409 |
| JSON valide, mais données incorrectes | 422 |
| Création réussie | 201 + Location |
| Suppression réussie | 204 |
Dans quel ordre tester ? D'abord l'authentification (401), puis l'existence de la ressource (404), puis la validité des données (422), puis les règles métier (409).
FastAPI valide le body avant d'exécuter votre fonction : il renverra un 422 avant que vous ayez pu vérifier la clé ou l'existence du cocktail. Pour respecter l'ordre ci-dessus, vérifiez l'authentification avec une dépendance (Depends), qui s'exécute avant la validation du body.
TP : Les avis
Objectif
Le patron d'API-ritif veut recueillir l'avis de ses clients. Le contrat est déjà écrit (design-first !) : à vous de coder la ressource /v1/cocktails/{cocktail_id}/reviews, en FastAPI.
Votre API sera corrigée automatiquement par une collection Bruno fournie par le formateur : chaque test passe ou échoue.
Ce TP est individuel et noté. On part d'un projet vide : reprenez l'installation de la page « Premiers pas avec FastAPI ».
Consignes
1 - Démarrer le projet
- Créez un projet FastAPI vide (port
8000). - Ajoutez la fonction
problem()et les gestionnaires d'erreurs de la page « Validation et codes de retour ». - Copiez ces données en mémoire :
# Les cocktails (seul l'id compte pour ce TP)
cocktails = [
    {"id": 1, "name": "Hello World"},
    {"id": 2, "name": "Null Pointer Mojito"},
    {"id": 3, "name": "Segfault Sunrise"},
    {"id": 4, "name": "Pull Request Colada"},
    {"id": 5, "name": "Kernel Panic"},
]

# Les clés d'API valides et le pseudo associé
api_keys = {
    "cle-neo": "neo",
    "cle-trinity": "trinity",
    "cle-morpheus": "morpheus",
}
2 - Le contrat à respecter
Il se trouve dans api-ritif.openapi.yaml, au tag Avis. En résumé :
| Route | Auth | Succès | Erreurs |
|---|---|---|---|
GET /v1/cocktails/{cocktail_id}/reviews | Non | 200 | 404, 422 |
POST /v1/cocktails/{cocktail_id}/reviews | X-API-Key | 201 + Location | 401, 404, 409, 422 |
GET /v1/cocktails/{cocktail_id}/reviews/{review_id} | Non | 200 | 404 |
Le body attendu pour créer un avis :
ReviewCreate:
  type: object
  required: [rating]
  additionalProperties: false
  properties:
    rating:
      type: integer
      minimum: 1
      maximum: 5
    comment:
      type: string
      maxLength: 500
Un avis renvoyé par l'API :
{
  "id": 7,
  "cocktail_id": 3,
  "author": "neo",
  "rating": 4,
  "comment": "Plante rarement, mais quel goût.",
  "created_at": "2026-10-14T10:32:00Z"
}
3 - Les règles
- Toutes les erreurs sont au format
application/problem+json. 401si la clé est absente ou inconnue. L'authorde l'avis est le pseudo associé à la clé : le client ne l'envoie jamais.404si le cocktail n'existe pas (y compris pour unGET).422si le body est invalide : note absente, hors de 1 à 5, pas un entier, commentaire trop long, champ inconnu… Le problème doit lister les champs en faute danserrors.409si ce client a déjà donné son avis sur ce cocktail.201en cas de succès, avec le headerLocation: /v1/cocktails/{cocktail_id}/reviews/{id}et l'avis créé dans le body.
4 - La pagination
La liste est paginée, triée du plus récent au plus ancien, et suit le format de la page « Filtres, tri et pagination » :
- paramètres
page(à partir de 1, 1 par défaut) etper_page(de 1 à 50, 5 par défaut), avec un422hors de ces limites ; - réponse
{"items": [...], "page", "per_page", "total", "_links"}; _linkscontient toujoursself,firstetlast, etprevetnextuniquement quand ils existent.
Une liste vide n'est pas une erreur : un cocktail sans avis renvoie 200 avec "items": []. Dans ce cas, last pointe vers la page 1.
5 - Tester
- Testez au fur et à mesure avec curl ou Bruno.
- Quand vous pensez avoir terminé, ouvrez la collection Bruno du formateur, réglez la variable
baseUrlsur votre serveur (http://localhost:8000/v1) et lancez toute la collection (Run).
Les tests de la collection s'enchaînent et créent des avis. Redémarrez votre serveur avant chaque exécution complète pour repartir de données vides.
Bonus
DELETE /v1/cocktails/{cocktail_id}/reviews/{id}:204pour l'auteur de l'avis,403pour les autres.- Un paramètre
?sort=sur la liste (rating,-rating,created_at,-created_at). - Le header
Linken plus de_links. - Comparez votre
/openapi.jsonau contrat fourni : quelles différences ?
Résultat attendu
- Le code de votre API (dépôt git ou archive, sans le dossier
.venv). - Une capture d'écran du résultat de la collection Bruno du formateur.
Pour aller plus loin : persistance et mock
Persister les données avec SQLite
Nos données en mémoire disparaissent à chaque redémarrage. SQLite stocke une base de données complète dans un simple fichier, sans serveur à installer. Idéal pour un prototype.
Python inclut le module sqlite3, rien à installer :
import sqlite3

db = sqlite3.connect("bar.db", check_same_thread=False)
db.row_factory = sqlite3.Row   # lignes accessibles comme des dictionnaires
db.execute("""
    CREATE TABLE IF NOT EXISTS cocktails (
        id INTEGER PRIMARY KEY,
        name TEXT UNIQUE NOT NULL,
        price REAL NOT NULL,
        alcohol_free INTEGER NOT NULL DEFAULT 0
    )
""")

# Lire
rows = db.execute("SELECT * FROM cocktails WHERE alcohol_free = ?", (1,)).fetchall()
items = [dict(r) for r in rows]

# Écrire
cur = db.execute(
    "INSERT INTO cocktails (name, price, alcohol_free) VALUES (?, ?, ?)",
    (cocktail.name, cocktail.price, cocktail.alcohol_free),
)
db.commit()
new_id = cur.lastrowid
Toujours des requêtes paramétrées (les ?), jamais de concaténation : "... WHERE name = '" + name + "'" est une porte ouverte à l'injection SQL. Le stagiaire de 2009 en sait quelque chose.
SQLite enregistre les booléens comme des entiers (0 ou 1). Pensez à les reconvertir avant de les renvoyer en JSON, sinon le contrat n'est plus respecté.
Simuler une API avec Prism
En design-first, le contrat existe avant le code. Prism en tire un faux serveur (mock) qui répond selon le contrat : le front peut commencer à travailler sans attendre le back. Prism nécessite Node.js (commande npx).
npx @stoplight/prism-cli mock api-ritif.openapi.yamlLe mock écoute sur http://127.0.0.1:4010, sans le préfixe /v1 du serveur :
curl -i http://127.0.0.1:4010/cocktails/3{"id": 3, "name": "Segfault Sunrise", "price": 9.5, "alcohol_free": false, ...}- Il renvoie les
exampledu contrat : de bons exemples rendent le mock utile. - Il valide les requêtes : un body invalide ou une clé manquante donne la réponse d'erreur prévue par le contrat.
- Le header
Preferforce une réponse précise, pour tester la gestion d'erreurs du client :
curl -i http://127.0.0.1:4010/cocktails/3 -H "Prefer: code=404"HTTP/1.1 404 Not Found
{"type": "about:blank", "title": "Not Found", "status": 404, "detail": "Ce cocktail n'existe pas. Pas encore."}Avec l'option -d (dynamic), Prism génère des données aléatoires conformes aux schémas au lieu des exemples. Pratique pour vérifier qu'un front ne casse pas avec un nom de 50 caractères.
Prism sait aussi se placer devant votre vraie API, en mode proxy, pour signaler chaque réponse qui ne respecte pas le contrat : npx @stoplight/prism-cli proxy api-ritif.openapi.yaml http://localhost:8000/v1.
Chapitre 8 - Sécurité et bonnes pratiques
L'authentification
Authentification ou autorisation ?
- Authentification : qui es-tu ? L'échec donne un
401 Unauthorized(mal nommé : il devrait s'appeler « Unauthenticated »). - Autorisation : as-tu le droit ? L'échec donne un
403 Forbidden.
Au bar : montrer sa carte de membre, c'est l'authentification. Le videur qui vérifie que la carte donne accès au carré VIP, c'est l'autorisation.
HTTP étant sans état, le client doit prouver son identité à chaque requête, en général dans le header Authorization.
La clé d'API
Une longue chaîne aléatoire, propre à chaque client, envoyée dans un header.
curl http://api-ritif.portlatch.com/v1/me -H "X-API-Key: ak_7f3c9e1b2d4a"- ✅ Très simple, idéale pour les échanges entre serveurs et les scripts.
- ❌ Elle ne périme pas toute seule : si elle fuite, elle reste valable jusqu'à sa révocation.
- ❌ Elle identifie une application plus qu'un utilisateur.
Une clé d'API est un mot de passe : jamais dans le code, jamais dans git, jamais dans une URL (?api_key=... finit dans les logs et l'historique du navigateur). Côté serveur, on la stocke hachée, comme un mot de passe.
Basic Auth
L'identifiant et le mot de passe, encodés en Base64, dans le header Authorization.
curl -u neo:redpill https://api.example.com/v1/me
# envoie : Authorization: Basic bmVvOnJlZHBpbGw=
Base64 est un encodage, pas un chiffrement : echo bmVvOnJlZHBpbGw= | base64 -d affiche neo:redpill. Sans HTTPS, c'est un mot de passe en clair.
Sessions ou tokens ?
| Session (cookie) | Token (JWT…) | |
|---|---|---|
| Principe | Le serveur garde la session en mémoire ou en base, le client garde un identifiant dans un cookie | Le client garde un jeton qui contient lui-même les informations, signé par le serveur |
| Envoi | Automatique par le navigateur (Cookie) | Manuel (Authorization: Bearer ...) |
| État côté serveur | Oui | Non : le serveur vérifie juste la signature |
| Révocation | Facile : on supprime la session | Difficile : le token reste valable jusqu'à son expiration |
| Adapté à… | Un site web classique | Une API, une application mobile, des microservices |
JWT
Un JSON Web Token est composé de trois parties en Base64url, séparées par des points :
eyJhbGciOiJIUzI1NiIsInR5cCI6IkpXVCJ9.eyJzdWIiOiIxMiIsIm5pY2tuYW1lIjoibmVvIiwicm9sZSI6ImN1c3RvbWVyIiwiZXhwIjoxNzk0NjQ0MDAwfQ.7xQ...
└────────── header ──────────────────┘ └──────────────────────────── payload ─────────────────────────────────────────────────────┘ └ signature
// header
{"alg": "HS256", "typ": "JWT"}
// payload (les « claims »)
{"sub": "12", "nickname": "neo", "role": "customer", "exp": 1794644000}- Le payload est lisible par n'importe qui : aucun secret dedans.
- La signature garantit qu'il n'a pas été modifié : changer
"role": "customer"en"bartender"invalide la signature. expfixe la date d'expiration (en secondes depuis 1970). Un token expiré donne un401.
Pour lire un payload :
import base64, json
json.loads(base64.urlsafe_b64decode(token.split(".")[1] + "=="))
Le site jwt.io décode les JWT visuellement. Ne collez jamais un vrai token de production dans un site tiers.
Avec API-ritif
# Échanger sa clé contre un JWT valable 15 minutes
curl -s -X POST http://api-ritif.portlatch.com/v1/auth/token -H "X-API-Key: $KEY"
# {"access_token": "eyJ...", "token_type": "Bearer", "expires_in": 900}

# L'utiliser
curl -i http://api-ritif.portlatch.com/v1/me -H "Authorization: Bearer $TOKEN"
Revenez dans 15 minutes : même requête, 401.
Les pièges
alg: none: certaines vieilles bibliothèques acceptaient un token « non signé ». Le serveur doit imposer l'algorithme attendu.- Durée de vie : courte (quelques minutes), avec un refresh token pour en obtenir un nouveau sans se reconnecter.
- Stockage dans le navigateur :
localStorageest lisible par n'importe quel script de la page (faille XSS). Un cookieHttpOnly; Secure; SameSiteest plus sûr.
OAuth2 : « Se connecter avec GitHub »
OAuth2 permet à une application d'agir au nom d'un utilisateur sur un autre service, sans jamais connaître son mot de passe.
Utilisateur        Application            GitHub (serveur d'autorisation)
    │ « Se connecter avec GitHub »                 │
    │──────────────────▶│                          │
    │        redirection vers GitHub               │
    │◀──────────────────│                          │
    │  se connecte et accepte les permissions      │
    │─────────────────────────────────────────────▶│
    │        redirection avec un « code »          │
    │◀─────────────────────────────────────────────│
    │──────────────────▶│  échange code ─▶ token   │
    │                   │─────────────────────────▶│
    │                   │◀─────────── access token │
    │                   │  appels d'API avec le token
│ │──────▶ api.github.comOn n'implémente jamais OAuth2 soi-même : on utilise un fournisseur (Keycloak, Auth0, Entra ID…) et une bibliothèque éprouvée.
HTTPS et CORS
HTTPS : non négociable
En HTTP, tout circule en clair : l'URL, les headers, le body. Sur le Wi-Fi de l'école, n'importe qui avec Wireshark peut lire votre clé d'API, votre token ou votre mot de passe.
HTTPS, c'est HTTP dans un tunnel TLS, qui apporte :
- la confidentialité : personne ne peut lire les échanges ;
- l'intégrité : personne ne peut les modifier en route ;
- l'authentification du serveur : le certificat prouve que vous parlez bien à
api-ritif.example.
Avec Let's Encrypt, un certificat est gratuit et se renouvelle automatiquement. Il n'y a plus aucune excuse.
Pour une API, ne redirigez pas HTTP vers HTTPS : refusez les requêtes HTTP. Quand la redirection arrive, la clé d'API est déjà passée en clair, et le client ne s'en rendra jamais compte.
CORS
La politique de même origine
| Page | Appelle | Même origine ? |
|---|---|---|
https://bar.example | https://bar.example/v1/cocktails | ✅ |
https://bar.example | https://api.bar.example/v1/cocktails | ❌ domaine différent |
http://localhost:8080 | http://localhost:3000/v1/cocktails | ❌ port différent |
http://bar.example | https://bar.example/v1/cocktails | ❌ protocole différent |
Sans cette règle, n'importe quel site que vous visitez pourrait appeler, avec vos cookies, l'API de votre banque.
Le mécanisme CORS
CORS (Cross-Origin Resource Sharing) permet à une API d'autoriser certaines origines. Le navigateur envoie l'origine de la page dans le header Origin, et l'API répond si elle l'accepte :
GET /v1/cocktails HTTP/1.1
Origin: http://localhost:5173

HTTP/1.1 200 OK
Access-Control-Allow-Origin: http://localhost:5173
Pour les requêtes « non simples » (un DELETE, du JSON, un header X-API-Key…), le navigateur envoie d'abord une requête preflight en OPTIONS pour demander la permission :
OPTIONS /v1/orders HTTP/1.1
Origin: http://localhost:5173
Access-Control-Request-Method: POST
Access-Control-Request-Headers: content-type, x-api-key

HTTP/1.1 200 OK
Access-Control-Allow-Origin: http://localhost:5173
Access-Control-Allow-Methods: GET, POST, DELETE
Access-Control-Allow-Headers: content-type, x-api-key
CORS est une protection du navigateur. curl, Bruno ou un script Python ne l'appliquent pas : c'est pour ça que tout marchait jusqu'ici. Et c'est pour ça que CORS ne protège pas votre API contre un attaquant : seule l'authentification le fait.
Manip : provoquer une erreur CORS
API-ritif n'autorise qu'une seule origine. Saurez-vous trouver laquelle ?
- Créez un fichier
index.html:<!doctype html> <meta charset="utf-8"> <title>Test CORS</title> <button id="go">Charger la carte</button> <pre id="out"></pre> <script> document.getElementById("go").onclick = async () => { const out = document.getElementById("out"); try { const res = await fetch("http://api-ritif.portlatch.com/v1/cocktails"); out.textContent = JSON.stringify(await res.json(), null, 2); } catch (e) { out.textContent = "Erreur : " + e.message; } }; </script> - Servez-le sur le port 8080 :
python3 -m http.server 8080, ouvrez http://localhost:8080 et cliquez. Lisez l'erreur dans la console des DevTools. - La même requête avec curl fonctionne. Comparez les headers de réponse avec et sans
Origin:curl -i http://api-ritif.portlatch.com/v1/cocktails -H "Origin: http://localhost:8080" - Indice : les développeurs front qui utilisent Vite connaissent bien le port
5173. Testez cette origine avec curl, puis servez la page sur ce port. - Modifiez le script pour passer une commande (
POST /v1/ordersavec du JSON et votreX-API-Key). Dans l'onglet Réseau, repérez la requêteOPTIONSenvoyée avant lePOST.
Configurer CORS sur son API
from fastapi.middleware.cors import CORSMiddleware

app.add_middleware(
    CORSMiddleware,
    allow_origins=["http://localhost:5173"],
    allow_methods=["*"],
    allow_headers=["*"],
)
Access-Control-Allow-Origin: * autorise tout le monde. C'est acceptable pour une API publique en lecture seule, jamais pour une API qui utilise des cookies.
Le rate limiting
Une API sans limite finit toujours par recevoir trop de requêtes : un script en boucle infinie, un client trop enthousiaste, un concurrent qui aspire vos données, ou une attaque par déni de service. Le rate limiting limite le nombre de requêtes par client et par période.
Exemple de réponse d'un barman débordé : « reviens dans 10 s ».
Pourquoi limiter ?
- Disponibilité : un seul client ne doit pas pouvoir monopoliser le serveur.
- Coûts : chaque requête coûte (calcul, base de données, appels à des services payants comme un LLM).
- Sécurité : ralentir les attaques par force brute sur une route de connexion.
- Modèle économique : offre gratuite à 60 requêtes par heure, offre payante à 5 000 (c'est le cas de l'API GitHub).
Les algorithmes
| Algorithme | Principe |
|---|---|
| Fenêtre fixe | 100 requêtes par minute, compteur remis à zéro à chaque minute. Simple, mais permet 200 requêtes en 2 secondes à cheval sur deux minutes. |
| Fenêtre glissante | 100 requêtes sur les 60 dernières secondes, à tout instant. Plus juste. |
| Seau à jetons (token bucket) | Le client a un seau de jetons qui se remplit à vitesse constante. Chaque requête consomme un jeton. Autorise de petites rafales. |
Ce que l'API doit répondre
HTTP/1.1 429 Too Many Requests
Retry-After: 10
Content-Type: application/problem+json

{"title": "Too Many Requests", "status": 429, "detail": "Le barman est débordé, reviens dans 10 s"}
Beaucoup d'API informent aussi le client avant qu'il atteigne la limite :
curl -i https://api.github.com/users/torvaldsx-ratelimit-limit: 60
x-ratelimit-remaining: 57
x-ratelimit-reset: 1794644000Les headers X-RateLimit-* sont une convention répandue mais non standard. L'IETF travaille à un standard (RateLimit et RateLimit-Policy), déjà supporté par certaines bibliothèques.
Le mettre en place
# pip install slowapi
from fastapi import Request
from slowapi import Limiter
from slowapi.errors import RateLimitExceeded
from slowapi.util import get_remote_address

limiter = Limiter(key_func=get_remote_address)
app.state.limiter = limiter

@app.exception_handler(RateLimitExceeded)
async def on_rate_limit(request: Request, exc: RateLimitExceeded):
    response = problem(429, "Too Many Requests", "Le barman est débordé, reviens dans une minute.")
    response.headers["Retry-After"] = "60"
    return response

@app.get("/v1/cocktails")
@limiter.limit("60/minute")
def list_cocktails(request: Request):   # le paramètre request est obligatoire
    ...
Limiter par adresse IP est un début, mais tous les étudiants d'une même salle partagent souvent la même IP publique. Une API authentifiée limite plutôt par clé ou par utilisateur.
En production, le rate limiting est souvent assuré en amont de l'application : par le reverse proxy (Nginx, Traefik), une passerelle d'API ou un CDN.
L'OWASP API Security Top 10
L'OWASP (Open Worldwide Application Security Project) est une fondation qui publie des références en sécurité applicative. Son API Security Top 10 recense les risques les plus fréquents dans les API. La dernière édition date de 2023.
La plupart de ces failles ne demandent aucune compétence technique avancée pour être exploitées : juste curl et un peu de curiosité. Comme pendant la chasse au trésor.
| # | Risque | Au bar, ça donne… | Se protéger |
|---|---|---|---|
| API1 | Broken Object Level Authorization (BOLA, aussi appelé IDOR) | Changer l'id dans /orders/42 et lire la commande d'un autre client | Vérifier à chaque requête que l'objet appartient à l'utilisateur |
| API2 | Broken Authentication | Une route de connexion sans limite d'essais, des tokens qui n'expirent jamais | Bibliothèques éprouvées, expiration, rate limiting sur l'authentification |
| API3 | Broken Object Property Level Authorization (BOPLA) | Envoyer {"role": "bartender"} dans un PATCH /me et devenir barman | N'accepter et ne renvoyer que les champs prévus (schémas stricts) |
| API4 | Unrestricted Resource Consumption | ?per_page=1000000, ou 10 000 commandes par seconde | Limites de pagination, de taille de body, rate limiting |
| API5 | Broken Function Level Authorization | Un client qui appelle /admin/scoreboard et obtient une réponse | Contrôler le rôle sur chaque route sensible, refuser par défaut |
| API6 | Unrestricted Access to Sensitive Business Flows | Un bot qui commande tous les 404 Spritz dès leur retour en stock pour les revendre | Détection des comportements automatisés, limites métier |
| API7 | Server Side Request Forgery (SSRF) | Une route « importer la photo du cocktail depuis une URL » à qui l'on donne http://localhost:8080/admin | Liste blanche de domaines, interdire les adresses internes |
| API8 | Security Misconfiguration | Les stack traces en production, CORS ouvert à tous, HTTP sans TLS | Configuration revue, erreurs neutres, HTTPS partout |
| API9 | Improper Inventory Management | L'API v0 du stagiaire de 2009, oubliée mais toujours en ligne | Inventaire des versions et des environnements, décommissionnement |
| API10 | Unsafe Consumption of APIs | Faire aveuglément confiance aux données renvoyées par l'API du fournisseur de citrons | Valider aussi ce qu'on reçoit des API tierces |
Les trois à retenir
Si vous ne deviez en retenir que trois, ce sont celles qui concernent l'autorisation : API1, API3 et API5. Elles ne sont détectées ni par les scanners automatiques, ni par les tests qui « vérifient que ça marche ». Il faut se demander, pour chaque route : et si c'était quelqu'un d'autre qui appelait ?
Le réflexe à prendre en écrivant une route : « Qui a le droit d'appeler cette route ? Sur quels objets ? Avec quels champs ? »
Référence complète : OWASP API Security Top 10 – 2023.
Chapitre 9 - HATEOAS
Les liens hypermédias
Sur un site web, vous ne tapez jamais d'URL à la main : vous arrivez sur la page d'accueil et vous cliquez sur des liens. Le site peut réorganiser toutes ses adresses, vous ne vous en rendez pas compte.
HATEOAS (Hypermedia As The Engine Of Application State) applique la même idée aux API : chaque réponse contient des liens vers les ressources liées et les actions possibles. Le client n'a besoin de connaître qu'une seule URL, le point d'entrée.
C'est la dernière contrainte de l'interface uniforme de REST, et le niveau 3 du modèle de Richardson (chapitre 2).
Partir du point d'entrée
curl -s http://api-ritif.portlatch.com/v1/{
"name": "API-ritif",
"version": "1.0.0",
"_links": {
"self": {"href": "/v1/"},
"cocktails": {"href": "/v1/cocktails"},
"customers": {"href": "/v1/customers", "method": "POST"},
"me": {"href": "/v1/me"},
"orders": {"href": "/v1/orders"},
"docs": {"href": "/docs"}
}
}On suit cocktails, puis le lien self d'un cocktail :
{
  "id": 3,
  "name": "Segfault Sunrise",
  "price": 9.5,
  "_links": {
    "self":    {"href": "/v1/cocktails/3"},
    "reviews": {"href": "/v1/cocktails/3/reviews"},
    "order":   {"href": "/v1/orders", "method": "POST"}
  }
}
Le cocktail indique lui-même où trouver ses avis et comment le commander. Aucune URL n'a été construite par le client.
Anatomie d'un lien
- La clé est la relation (rel) : elle dit ce que représente le lien par rapport à la ressource courante.
hrefest l'adresse.method(extension d'API-ritif) précise la méthode HTTP quand ce n'est pasGET.
Les relations courantes
Certaines relations sont standardisées par l'IANA, et tout le monde les comprend :
| Relation | Sens |
|---|---|
self | La ressource elle-même |
next, prev, first, last | Navigation dans une liste paginée |
collection | La collection à laquelle appartient l'élément |
item | Un élément d'une collection |
related | Une ressource liée |
edit | L'adresse pour modifier la ressource |
Les autres sont propres à votre métier : cancel, reviews, order, pay… Choisissez des noms explicites et documentez-les.
Ce que ça change pour le client
- Le serveur peut changer ses URL sans casser les clients, puisqu'ils suivent les liens.
- Le client découvre ce qui est possible au lieu de le deviner.
- Les règles métier restent côté serveur : si une action n'est pas permise, son lien n'apparaît pas (page « Des liens qui dépendent de l'état »).
Vous utilisez HATEOAS depuis le chapitre 4 sans le savoir : parcourir une liste en suivant _links.next, c'est exactement ça.
HAL et JSON:API
REST dit qu'il faut des liens, mais pas comment les écrire. Plusieurs formats se sont imposés. Voici la même commande dans les deux plus répandus.
HAL
HAL (Hypertext Application Language, type application/hal+json) est le plus simple : on garde son JSON habituel et on ajoute deux clés réservées.
_links: les liens, indexés par relation ;_embedded: des ressources liées incluses directement, pour éviter des requêtes supplémentaires.
{
  "id": 42,
  "status": "pending",
  "price": 9.5,
  "_links": {
    "self":     {"href": "/v1/orders/42"},
    "cocktail": {"href": "/v1/cocktails/3"}
  },
  "_embedded": {
    "cocktail": {
      "id": 3,
      "name": "Segfault Sunrise",
      "_links": {"self": {"href": "/v1/cocktails/3"}}
    }
  }
}
HAL permet aussi des liens modèles (templated), à compléter par le client :
"search": {"href": "/v1/cocktails{?tag,max_price}", "templated": true}JSON:API
JSON:API (type application/vnd.api+json) va beaucoup plus loin : il impose la structure complète du document, la pagination, les filtres, le tri, les erreurs et les relations.
{
  "data": {
    "type": "orders",
    "id": "42",
    "attributes": {
      "status": "pending",
      "price": 9.5
    },
    "relationships": {
      "cocktail": {
        "data": {"type": "cocktails", "id": "3"},
        "links": {"related": "/v1/cocktails/3"}
      }
    },
    "links": {"self": "/v1/orders/42"}
  },
  "included": [
    {
      "type": "cocktails",
      "id": "3",
      "attributes": {"name": "Segfault Sunrise"}
    }
  ]
}
La syntaxe de tri ?sort=-price,name utilisée dans ce cours vient de JSON:API.
Comparatif
| HAL | JSON:API | |
|---|---|---|
| Philosophie | Ajouter des liens à son JSON | Un format complet et strict |
| Données | À la racine, comme d'habitude | Dans data.attributes |
| Ressources incluses | _embedded | included |
| Actions (méthode, champs) | Non prévu | Non prévu |
| Prise en main | Immédiate | Il faut lire la spécification |
| Outillage | Correct | Bibliothèques dans la plupart des langages |
Les autres
- Siren décrit aussi les actions possibles : méthode, URL et champs à envoyer, comme un formulaire HTML.
- JSON-LD (et son extension Hydra) vient du web sémantique : il relie les données à des vocabulaires partagés. Google l'utilise pour les données structurées des pages web.
Et API-ritif ?
API-ritif utilise un style inspiré de HAL : des _links indexés par relation, avec un champ method en plus pour les actions. Ce n'est pas du HAL strict, et c'est très courant : beaucoup d'API prennent ce qui les arrange dans HAL.
Pour vos propres API, aucun format n'est imposé. Ce qui compte : des liens cohérents, partout pareils, et documentés dans le contrat.
Des liens qui dépendent de l'état
C'est là que HATEOAS devient vraiment utile : les liens ne décrivent pas seulement les ressources liées, mais aussi ce qu'on a le droit de faire maintenant.
La vie d'une commande
pending ──(30 s)──▶ preparing ──(2 min)──▶ ready ──▶ served
   │
   └──▶ cancelled   (uniquement tant qu'elle est pending)
Juste après la commande :
{
  "id": 42,
  "status": "pending",
  "cocktail": "Segfault Sunrise",
  "_links": {
    "self":     {"href": "/v1/orders/42"},
    "cancel":   {"href": "/v1/orders/42", "method": "DELETE"},
    "cocktail": {"href": "/v1/cocktails/3"}
  }
}
30 secondes plus tard, le barman a commencé. Même requête :
{
  "id": 42,
  "status": "preparing",
  "cocktail": "Segfault Sunrise",
  "_links": {
    "self":     {"href": "/v1/orders/42"},
    "cocktail": {"href": "/v1/cocktails/3"}
  }
}
Le lien cancel a disparu. Le serveur ne dit pas « tu ne peux plus annuler parce que le statut est preparing » : il ne propose simplement plus l'action.
Faites l'essai : commandez un cocktail et interrogez la commande toutes les 10 secondes avec curl. Regardez le lien disparaître en direct.
Côté client : suivre les liens, pas les règles
Sans HATEOAS, le client doit connaître la règle métier :
# ❌ La règle est dupliquée dans le client
if order["status"] == "pending":
    show_cancel_button()
Le jour où le bar autorise l'annulation pendant la préparation, il faut mettre à jour toutes les applications : web, mobile, caisse… Avec HATEOAS, le client se contente de regarder si le lien existe :
order = requests.get(urljoin(BASE, "/v1/orders/" + str(order_id)), headers=headers).json()

cancel = order["_links"].get("cancel")
if cancel:
    print("Annulation possible")
    requests.request(cancel["method"], urljoin(BASE, cancel["href"]), headers=headers)
else:
    print("Trop tard, le shaker tourne déjà")
La règle n'existe qu'à un seul endroit : le serveur. Il peut la changer, tous les clients suivent.
Ça marche aussi pour les droits
Les liens peuvent dépendre de qui demande, pas seulement de l'état :
- un barman voit un lien
servesur les commandesready, un client non ; - l'auteur d'un avis voit un lien
delete, les autres non ; - un client authentifié voit un lien
ordersur un cocktail, un visiteur anonyme voit un lienregister.
Masquer un lien n'est pas une protection : le serveur doit toujours vérifier l'état et les droits quand l'action arrive. Un DELETE envoyé à la main sur une commande en préparation doit toujours répondre 409.
Pourquoi HATEOAS est rare
Fielding le répète depuis 2008 : sans hypermédia, ce n'est pas REST. Pourtant, la grande majorité des API publiques s'arrêtent au niveau 2 de Richardson. Pourquoi ?
Les raisons
Les clients codent quand même les URL en dur
La promesse « le serveur peut changer ses URL sans casser les clients » suppose que les clients suivent réellement les liens. En pratique, les développeurs lisent la documentation et écrivent /v1/orders/42 directement dans leur code. Le bénéfice disparaît.
Un client ne comprend pas une relation inconnue
Pas de standard unique
HAL, JSON:API, Siren, JSON-LD… Chaque format a ses outils, et aucun ne s'est imposé. Beaucoup d'équipes préfèrent ne rien choisir.
Des réponses plus lourdes
Des liens dans chaque élément d'une liste de 100 éléments, c'est du volume en plus, et du code serveur en plus pour les calculer selon l'état et les droits.
OpenAPI couvre une partie du besoin
La découverte de l'API se fait avec la documentation et les clients générés plutôt qu'à l'exécution.
Là où c'est utile
HATEOAS n'est pas tout ou rien. Certaines parties rendent service dans presque toutes les API :
- La pagination :
next,prev,first,last. Presque toutes les API sérieuses le font. - Les workflows : commandes, paiements, validations… les liens d'actions selon l'état évitent de dupliquer les règles métier dans chaque client.
- Le header
Locationaprès une création : c'est déjà un lien hypermédia. - Les agents IA : un LLM qui découvre une API, lui, sait lire un lien qu'il n'a jamais vu et en déduire quoi faire. Un point d'entrée avec des liens explicites l'aide à naviguer sans documentation.
L'API REST de PayPal, par exemple, renvoie dans chaque paiement une liste de liens (approve, capture…) avec leur méthode HTTP. Le client suit le lien approve pour rediriger l'acheteur, sans construire l'URL.
En résumé
| ✅ Pour | ❌ Contre |
|---|---|
| Le client suit des liens au lieu de construire des URL | Les clients codent souvent les URL en dur quand même |
| Les règles métier restent côté serveur | Un client ne sait pas gérer une relation inconnue |
| L'API se découvre depuis un point d'entrée | Pas de format standard unique |
| Utile pour la pagination, les workflows et les IA | Réponses plus lourdes, serveur plus complexe |
La position raisonnable : des liens de pagination partout, des liens d'actions là où l'état compte, et une bonne documentation OpenAPI à côté.